先算物理,再画像素:DeXplicit 的显式 3D 操控世界模型拆解
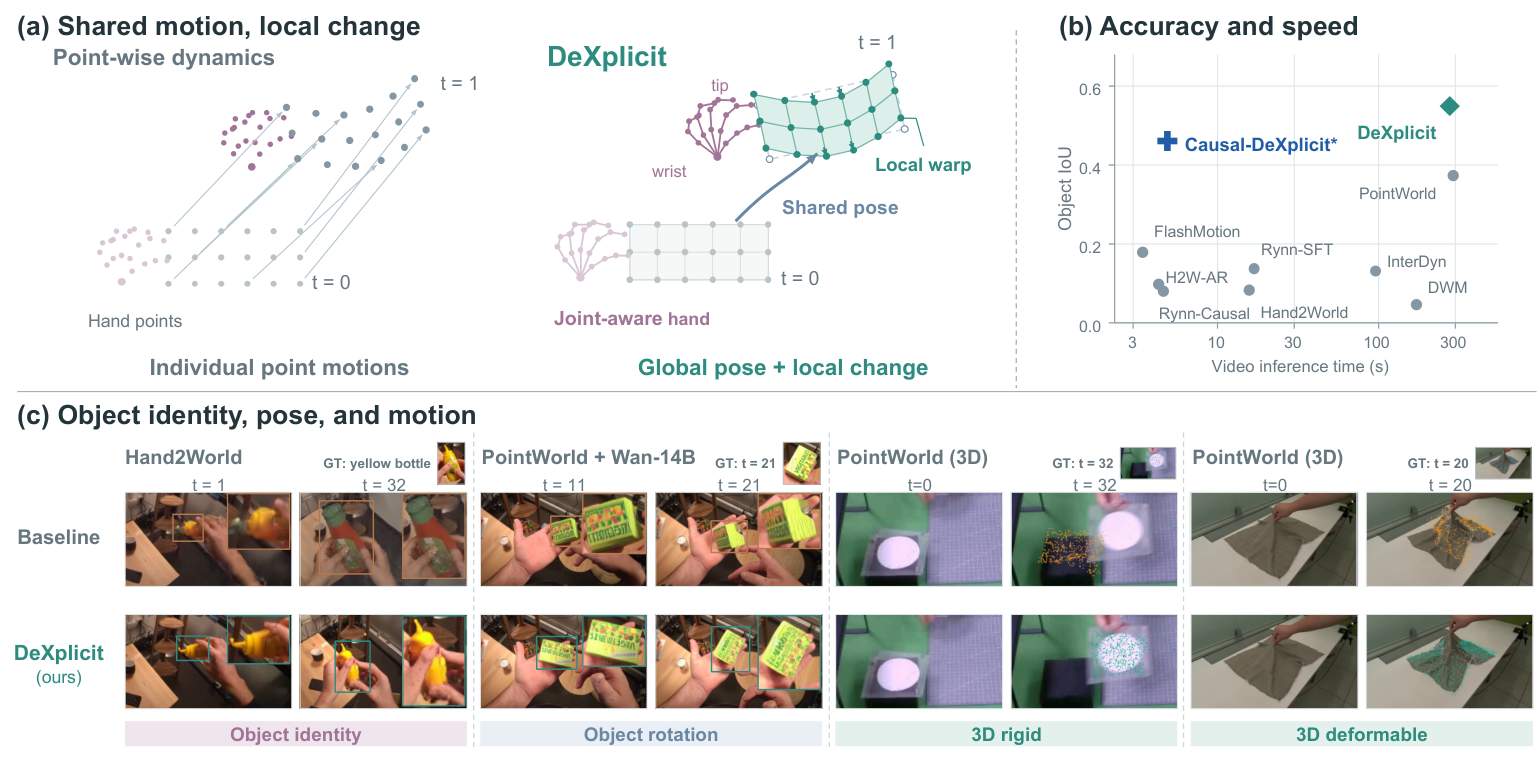
这一周有两篇世界模型的论文在讲同一个故事的上下半段:Inside-JEPA 从内部说"潜状态要真的有语义",DeXplicit 从外部说"显式的几何比隐式的像素更可靠"。后者给的数字相当有说服力:移动点误差降低 27~40%,物体保真度 IoU+ 提升 47%,而且因为改成了因果两步生成,视频合成快了 57 倍。
这篇拆解一个具体问题:当你要预测"手拿着杯子倒水,接下来 32 帧会怎样",到底应该让视频生成模型自己在像素里学物理,还是先把物理算出来再让渲染器去画。
一、现有做法的两个病根
DeXplicit 把问题诊断得很清楚。生成式的操控世界模型有两条主流路线,各有各的病:
病根一:视频生成模型把三件事搅在一起。动作条件动力学、相机运动、视觉合成,全部压在一个视频 diffusion 模型里。结果是模型必须从像素里隐式地学出物理——而像素级的重建损失对几何一致性几乎没有约束力。
病根二:点轨迹表示没有显式物体结构。另一条路把动力学表示成点轨迹(PointWorld 这一类),比视频生成好,但点云本身没有"这是一个杯子"的概念,多步 rollout 时形状会漂移。
DeXplicit 的主张是显式 3D 先行:给定初始场景和未来的手部轨迹,一个轻量 3D 动力学网络先预测以物体为中心的运动与形变,产出结构化、有几何意义的世界状态;然后这些预测成为视频生成的脚手架——外观沿着预测出的 3D 运动被搬运并投影到未来视角,渲染器只需要去补全那些"不确定和新露出来的内容"。
二、Pipeline:三段式
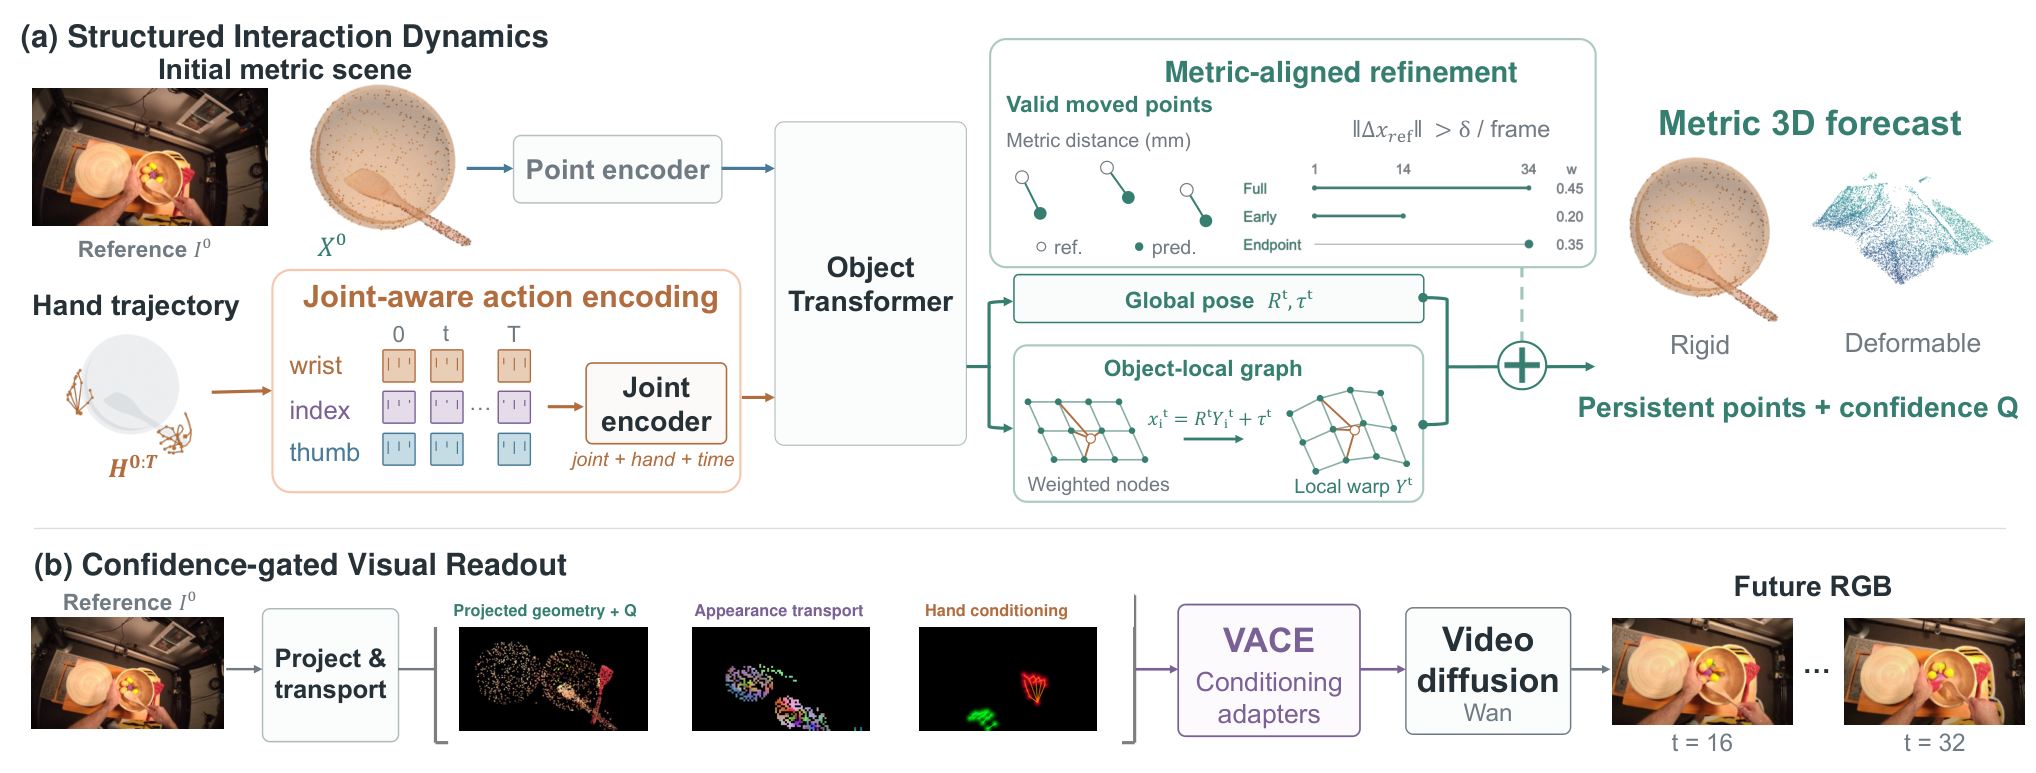
论文的架构图很清楚,我按它的三段来说:
- 联合感知的动作编码(joint-aware action encoding):手部 3D 关节轨迹被编码成条件,不是简单的点序列。
- 以物体为中心的度量动力学:分成共享的物体运输(rigid transport,保持几何)和局部形变(local deformation)两条路径——这是它和 PointWorld 的核心区别,物体几何和位姿变化被分开处理,几何不会被 rollout 侵蚀。
- 度量对齐的精修 + 条件化渲染:把预测的 3D 几何投影到目标视角,加上手部条件和外观搬运,喂给渲染器。
动力学模块用的是 Point Transformer V3,编码器和解码器分阶段从粗到细执行。
三、数字
3.1 3D 动力学预测
在 HOT3D、OakInk2、PhysTwin 三个数据集上,与 PointWorld 对比(两种方法收到完全相同的初始度量场景点和 3D 手部关节轨迹)。单位是毫米 L2 误差:
| 数据集 / 时域 | PointWorld(移动点 / 全点) | DeXplicit(移动点 / 全点) |
|---|---|---|
| HOT3D 长时域 1–32 | 90.47 / 18.17 | 54.34 / 14.01 |
| OakInk2 长时域 1–32 | 83.21 / 11.71 | 59.95 / 16.88 |
| PhysTwin 长时域 1–32 | 60.41 / 35.52 | 44.04 / 25.37 |
| HOT3D 早期 1–14 | 70.00 / 12.16 | 39.21 / 8.65 |
| OakInk2 早期 1–14 | 35.80 / 6.70 | 20.61 / 8.01 |
| PhysTwin 早期 1–14 | 41.71 / 23.80 | 21.81 / 13.60 |
早期时域误差降 42~48%,长时域降 27~40%。但OakInk2 的全点误差反而升高了(11.71 → 16.88,1–32;6.70 → 8.01,1–14)——论文没有掩盖这一点,摘要里也写明了"全点误差在 HOT3D 和 PhysTwin 上改善,但在 OakInk2 上更高"。
怎么理解这个例外?我的判断是:DeXplicit 优化的是"被移动的物体"的准确性,而 OakInk2 上场景里有大量不该动的背景/静态部分,DeXplicit 对这些点的预测反而不如 PointWorld 的自由形变更稳。这其实印证了方法本身的设计意图——它是物体中心的,不是全场景的。
3.2 视频生成
共享渲染器下的对比(480×832,未来帧 1–32):
| 方法 | PSNR ↑ | LPIPS ↓ | PCK20 ↑ | 物体 IoU+ ↑ | 推理耗时 ↓ |
|---|---|---|---|---|---|
| DeXplicit | 19.13 | 0.274 | 40.3% | 0.549 | 277.44 s |
| Causal-DeXplicit | 17.41 | 0.348 | 44.7% | 0.490 | 4.90 s |
| PointWorld(适配) | 18.01 | 0.315 | 27.3% | 0.373 | 291.18 s |
| Hand2World | 14.32 | 0.497 | 54.9% | 0.082 | 15.76 s |
| Hand2World-AR | 13.47 | 0.604 | 57.0% | 0.080 | 4.62 s |
| RynnWorld-Causal | 14.70 | 0.566 | 25.8% | 0.097 | 4.33 s |
这张表里有一行值得停下来看:Hand2World 的手部对齐 PCK20 高达 54.9%,但物体 IoU+ 只有 0.082,CLIP 前景相似度只有 22.1%。论文对此的评语很准——"手部对齐度高并不等于交互保真度高"。手对得很准,但杯子不见了。这就是"像素级生成"和"显式几何约束"的差别,也是我认为这篇论文最大的价值点:它给出了两个独立指标,而现有榜单经常只报一个。
3.3 57× 加速从哪来
DeXplicit 双向上下文版本(14B)跑完整 32 帧要 277.44 秒。改成两步行因果生成(每个 block 只去噪两步,且条件在已生成历史上)之后,只要 4.90 秒——4 帧 0.54 秒。相对 14B 双向上下文是 57×。
为什么能这么快?因为物理已经被算完了:渲染器不再需要从像素里推理"物体会怎么动",只需要把已经算好的运动搬运过去,再补全新露出来的内容。自由度被砍掉了,迭代次数自然能砍。
3.4 消融:每一步都算数
3D 动力学消融(状态 1–34,L2 毫米):
| 配置 | 移动点 ↓ | 全点 ↓ |
|---|---|---|
| 直接预测点 | 63.35 | 13.58 |
| + 动作差异 | 59.84 | 13.10 |
| + 联合感知编码 | 56.18 | 11.76 |
| + 结构化运输 | 51.08 | 9.50 |
| + 度量对齐监督 | 50.18 | 9.36 |
| + 规范化局部图 | 49.25 | 9.23 |
"结构化运输"这一步单独贡献了最大的一次跳变(56.18 → 51.08,全点 11.76 → 9.50)——也就是把几何保持和位姿变化分开建模。这一步是全篇设计的核心,其余几项都是增量优化。
四、我的判断
最值得带走的一条:
- 显式几何和生成式外观是互补的,不是二选一。DeXplicit 的分工很清晰:物理用几何算,外观用生成算。这条边界划得好,比"什么都塞进视频模型"健壮得多。
- "物体中心"而非"场景中心"是更实用的抽象。多数真实任务只关心几个被操作的物体。DeXplicit 把预算花在物体上,OakInk2 全点误差变差恰恰是代价的体现——这个方法在"少数物体 + 长时序"场景收益最大,在"全场景稠密变化"场景要重新评估。
- 报告两个独立指标,而不是一个。PCK20(手部对齐)和 IoU+(物体保真)必须一起看。只报 PCK20 的方法可能完全不保物体保真度——Hand2World 就是活例子。做内部评测时请把这两个指标都列上。
要留意的局限:
- 需要一个可靠的 3D 动力学模块。DeXplicit 的效果建立在一个"轻量 3D 动力学网络能预测物体运动"的前提上。如果你的场景涉及高度非刚体(绳、布料、流体)、强接触或严重遮挡,这一步的误差会直接传导到渲染端。这篇论文的三个数据集都是桌面级灵巧操作,泛化到工业场景要谨慎。
- 双向上下文版本 277 秒,这在真机上完全不可用。57× 的加速是拿"改成因果两步行"换来的,而因果版本在 PSNR(19.13 → 17.41)和物体 IoU+(0.549 → 0.490)上是有损失的。你必须接受这档质量折损才能拿到速度。
- 没有公开代码链接。论文只给了项目页(dexplicit.github.io),arXiv 页面的 Comments 里没列 GitHub 仓库。如果要复现,动力学模块(Point Transformer V3)和条件化接口的细节都得自己啃。
一句话总结:DeXplicit 的核心主张是"把物理从像素里搬出来"——这不只是为了更准,更是为了让生成模型可以做更少的事,从而快一个数量级。当你的世界模型瓶颈在渲染时,这条路值得认真评估。
参考资料
- 论文:DeXplicit: Making Physical State Explicit in Dexterous Manipulation World Models — Adam Lee, Mutian Xu, Yukang Cao, Shulin Tian, Ziwei Liu,arXiv:2610.30781,2026
- 项目页:https://dexplicit.github.io
- 许可:CC BY 4.0(本文引用图均出自该论文并已标注出处)