让世界模型的内部状态说人话:Inside-JEPA 的关系接地实验
JEPA 系世界模型有个众所周知的尴尬:它能规划,但没人知道它在想什么。探针能从一个训练好的潜在状态里读出"杯子在碗里",但状态的任何一部分都没有被分配去承载这个关系——所以你没法用关系去写目标,也没法用关系去陈述模型的信念。Inside-JEPA(Adelaide University AIML,2026)做了一件我很少见到的工作:它不是提出一个新架构,而是用受控实验去回答"潜状态里的关系通道到底能不能落地、靠什么落地"。
结论有点反直觉,也很有工程价值。
一、问题:状态是隐变量,不是符号
先把问题摆清楚。JEPA 这类模型预测的是目标编码器的嵌入而不是像素,它的取舍是"忽略不可预测的、保留对行动重要的"。这让规划极其高效,但也让状态变成一坨不透明的向量。
论文里有个说法我觉得很准:探针能读出关系,不代表模型"拥有"关系。区别在于语义接地——如果状态里没有任何一部分被承诺去表示"在……里面",那你既不能用这个关系写目标,也不能用这个关系陈述模型的信念。而关系(物体之间的几何谓词)恰恰是人和机器沟通的自然词汇。
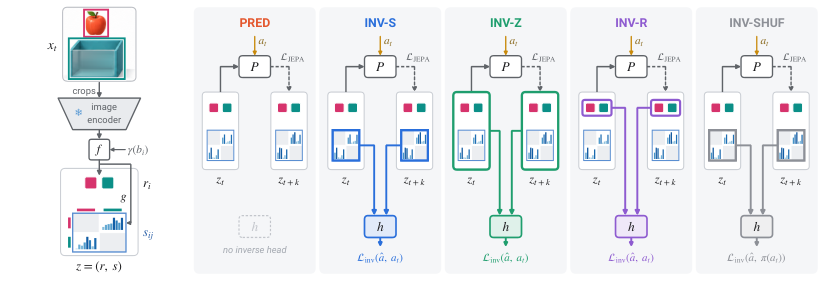
直接补救办法是把关系写进状态:对每个有序实体对,放进一组软符号向量(论文叫 relational channels,关系通道),让预测器像处理潜状态其余部分一样消费和预测它们。关键设计是——这些通道只用世界模型自己的目标来训练,完全不用关系标注。这和"用监督头从表征里读谓词"的神经符号流水线有本质区别。
但这里立刻冒出一个符号接地问题:潜预测目标里没有任何东西规定这些通道应该表示什么。预测器用一个静态码、一个乱变的码,和用一个真的编码关系的码,对它来说没有区别。
二、方法:只加一项损失
Inside-JEPA 的改动极小:在 JEPA 目标上加一项逆动力学损失——一个头必须从关系通道(变化前和变化后)里恢复出动作。
这个设计的精妙之处在于梯度路径。如果逆动力学头只读实体潜变量,那动作可以被解码得很准,但通道照样不落地;只有当头必须读通道、并且梯度从通道回传时,动作标签才被迫去解释"关系通道怎么变"。这正是符号接地在真实视频世界模型里的一个干净实例。
三、关键数字
论文用了非常严格的评测协议,值得先说一句:每个关系用匈牙利匹配只配一个通道,并且每个模型都要额外和"随机初始化的关系头"比分——后者看到完全相同的框几何信息。这一条是为了防止"后验匹配总能找出并不存在的意义"。
3.1 纯预测不落地,逆动力学才落地
在 Something-Something V2 上:
| 设置 | INV-S 相对 PRED 的匹配关系 AUROC 增益 |
|---|---|
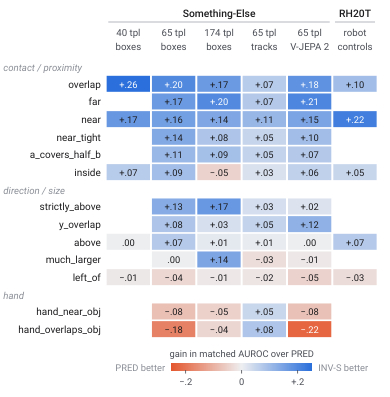
| 标注框,10 个设置 | +.065 ~ +.103 |
| RH20T 机器人片段(留出任务) | +.081 |
| 现成检测+跟踪物体,5 个关系 | +.050 ~ +.061 |
| 跟踪物体 + 13 个关系 / 冻结 V-JEPA 2 编码器 | +.016 ~ +.042(最小) |
| Figure 4 全部 18 个设置 | 增益全部为正 |
最狠的一句在正文里:纯潜预测的表现"不比随机关系头更好"。也就是说,如果不加逆动力学,你从 JEPA 状态里探出来的关系语义,很可能大部分是探针自己拟合出来的,而不是模型内部真的编码了。这对整个"用探针解释世界模型"的做法是一个警告。
3.2 什么在起作用,什么不起作用
这是我认为全文最有价值的部分,因为作者花了大量篇幅做否证:
- 解码动作准 ≠ 落地。把逆动力学头放在实体潜变量上,动作解码最准,但通道几乎不动(INV-Z 臂)。
- 打乱标签不落地。用打乱的标签做同样的逆动力学,通道和纯预测没区别(INV-SHUF 臂)。
- 无标签目标不落地。两个无标签目标——箭头 of time(AOT-S)和 InfoNCE(NCE-S)——都失败。
- 只有 5% 的对子带标签也不落地。而且 Table 13 显示:没有任何低于 100% 的标签比例能通过 C1 判据,25% 只差 .003 没过。
翻译成工程语言:接地需要"通道自己必须去解释的正确动作标签",而且需要成千上万个。不是"有一点监督总比没有好"——在这个机制里,错误的标签不是弱监督,是反向监督。
3.3 落地之后能干什么
两个用途都有数字支撑:
- 关系变化预测。给定动作,预测出的关系变化 AUROC .599,对比真实观测到的未来关系 .621——已经很接近了。用打乱的动作则失效。
- 从关系目标做一步动作选择。用 16 个关系通道的有监督读出,在 65 个候选动作里把正确动作排进 top-5 的比例是 43%,纯预测潜状态的整体探针是 24%,频率先验 17%。
跟踪物体场景下,预测的动作效应达到标注框场景的 86%——意味着你不一定需要精确标注框才能拿到大部分好处。
3.4 接地的边界在哪
作者诚实地列了失败的地方,这部分反而最有信息量:
- left_of 在真实视频上从不落地。相对接触、接近、竖直关系能落地,left_of、much_larger 和手部关系不能。
- 编码是分布式的,不是"一个通道对应一个关系"。单个匹配通道的读出效果,明显弱于对全部 16 个通道做探针。
- 离有监督上限还有距离,但也说明这个方向有空间——论文专门算了"逆动力学追回了有监督上限的多少比例"。
四、我的判断
这篇论文真正的价值不在方法,在方法论。
- 它给"探针解释世界模型"这条流行路线泼了一盆必要的冷水。如果你打算用线性探针从 JEPA 状态里读出关系来证明"模型内部编码了物理关系",请先做 Inside-JEPA 的对照:加一个随机关系头的基线。成本极低,但能挡掉大部分自欺欺人。
- "必须读通道"这个约束是通用的接地技巧。把辅助任务的输入强行限定为目标通道,是让辅助损失真正塑造表征而不是绕过它的标准做法。这个模式可以直接搬到你的项目里:想验证某个潜变量真的有语义,就让一个辅助头只能读它。
- 负结果比正结果更值得抄。标签要 100% 正确、要成千上万、5% 不行、25% 差一点不行——这些数字换算成工程语言是:你的动作标注质量决定了关系语义的落地质量,没有中间态。有脏标注的团队要清醒。
要留意的局限:
- 关系是 2D 框上的几何谓词,论文自己说明了"inside 表示图像平面上的包含代理"。这不是真正的 3D 物理关系,把它当成"物理理解"的证据会过头。
- left_of 不落地这件事值得警惕。为什么左右关系难而上下容易?论文给了容量假设(K=32 时多出的通道会分配给已经能落地的关系),但没有给出定论。这提醒我们:关系通道的容量分配本身就是一个未解决的设计问题,不是调参能绕过的。
- 冻结 V-JEPA 2 编码器时增益最小(+.016 ~ +.042)。也就是说这个方法更像是"锦上添花"而非"雪中送炭"——它让已有的潜状态更可读,但不会凭空创造语义。做工程决策时要清楚这一点:如果你的基座编码器根本不会编码关系,接地也救不回来。
一句话总结:Inside-JEPA 证明了世界模型里的符号接地是可以在真实视频上被可靠测量的,并给出了一把相当锋利的尺子——加一个随机头做对照。带着这把尺子去测你自己的模型,大概会发现一些不太舒服但很有价值的事实。
参考资料
- 论文:Inside-JEPA: From Prediction to Relational Grounding in Latent World Models — Hossein Resani, Javen Qinfeng Shi(Australian Institute for Machine Learning, Adelaide University;Responsible AI Research Centre),arXiv:2610.31194,2026
- 许可:CC BY 4.0(本文引用图均出自该论文并已标注出处)
- 延伸阅读:LaLa-World —— 用语言做动作接口的世界模型,与本文互为"接口"与"内部语义"两侧的参考