把安全和奖励塞进同一个 Bellman 方程:Unified Bellman Operator 拆解
安全强化学习一直卡在一个二选一:要么你事先知道安全边界,用安全滤波器给出硬保证,但代价是牺牲任务性能;要么你把安全和奖励一起学,但只得到"平均意义上安全"的概率保证。普林斯顿 2026 年这篇 A Unified Bellman Operator for Safety-Critical Reinforcement Learning 想做的,是把这个二选一变成"一个 Bellman 算子"。
它的实现(JointSAC)在 11 个带对抗扰动的连续控制环境上,违规成本几乎全为零,同时任务回报是所有基线里最高的——注意是"几乎为零"而不是"平均为零",这个区别是全文的技术核心。
一、问题:两种范式各自的死结
先把当前的谱系摆清楚,因为论文的贡献恰恰在于它没有站在任何一边。
Model-free + CMDP 路线(PPO-Lag、SAC-Lag、PCPO):把安全约束塞进目标函数,用 Lagrangian 对偶或信任域投影处理。问题在于它约束的只是期望累计成本——"平均不越界",不是"永不越界"。安全保证是概率性的。
Model-based / 滤波器路线:预测未来、显式避开不安全集合,给出严格保证。代价有三:模型偏差会累积(compounding model bias)、实时推断开销大、而且在复杂或未建模的动力学下容易失准。
论文对"解耦式"设计(先训一个任务无关的安全滤波器,再把不安全动作投影回安全集)提出了一个我认为是全文最实际的批评:这种 switch 型干预只在边界附近才触发。当一个不考虑安全的任务策略持续想冲出边界时,滤波器就会反复开关,产生抖动(jittery)干预——在 human-in-the-loop 场景里这特别不可接受。
还有两条近路:Q-CBF(预计算安全值函数当控制屏障函数)避免了规划延迟,但需要在线做动作投影;离线可行性引导模型(用 diffusion / flow-matching / 世界模型逼近最大可行域)要么引入在线迭代延迟,要么靠事后蒸馏从而削弱硬保证。而"外部投影"本身会引入 action aliasing——同一个被投影的动作可能对应多个原始意图,这对下游学习不友好。
最后是统一架构路线(把安全直接嵌进策略):问题是联合优化奖励和成本会因梯度冲突而破坏学习稳定性,必须靠梯度操作或显式潜变量解耦这类算法技巧来救。
二、核心:换一个 Bellman 算子,而不是换策略
这篇论文的立场很明确:不要在策略层面耦合安全和任务,要在价值函数层面耦合。
具体做法是提出一个联合 Bellman 算子,把任务回报和安全裕度统一进一个 joint value function。论文说这个算子是从鲁棒最优停止理论(robust optimal stopping)推导出来的——这是它和纯 CMDP 家族最大的理论区别:安全被建模成一个对抗的零和博弈,而不是一个可以被 Lagrangian 权衡掉的软约束。
数学上,设环境是带扰动 d 的 MDP,联合策略 π = (μ, ν) 同时输出动作和对抗扰动响应。奖励 r(s,a,d) 和安全裕度 g(s) 分别定义,约束集 Fc = {s : g(s) ≥ 0},viability kernel Ω 是"无论对抗扰动如何都能永远避开失败集"的状态子集。联合价值函数刻画的是"在安全约束下的最优任务回报",而关键结论是:收敛之后得到的策略在最大化任务回报的同时,在所有时刻都保持安全——不是平均安全,是随时安全。
三、怎么学:两个时间尺度
推导出一个 Bellman 算子不算完,你还得能学它的不动点。论文用两时间尺度随机逼近解决:
- 快时间尺度:跟踪学习中的联合策略的安全价值(安全 critic)。
- 慢时间尺度:估计联合价值。
收敛性通过把极限动力学表述为一个occupation-averaged differential inclusion(占据平均微分包含)来保证,并证明它渐近收敛到一组极限最优的安全约束任务价值函数。理论上还证明了安全集的前向不变性(forward invariance)——一旦进了安全集就永远留在里面,这是"随时安全"的形式化表述。
实现是 JointSAC:在 SAC 基础上,参照 ISAACS 框架,用梯度下降-上升(τ-GDA)的有限时间尺度分离来训练控制策略和对抗扰动策略。
四、数字
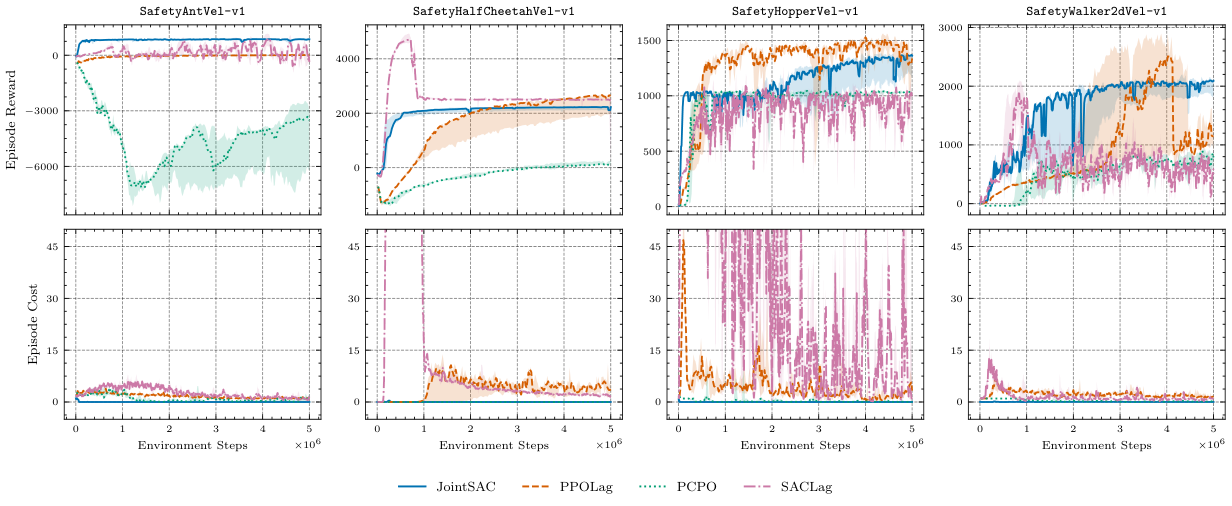
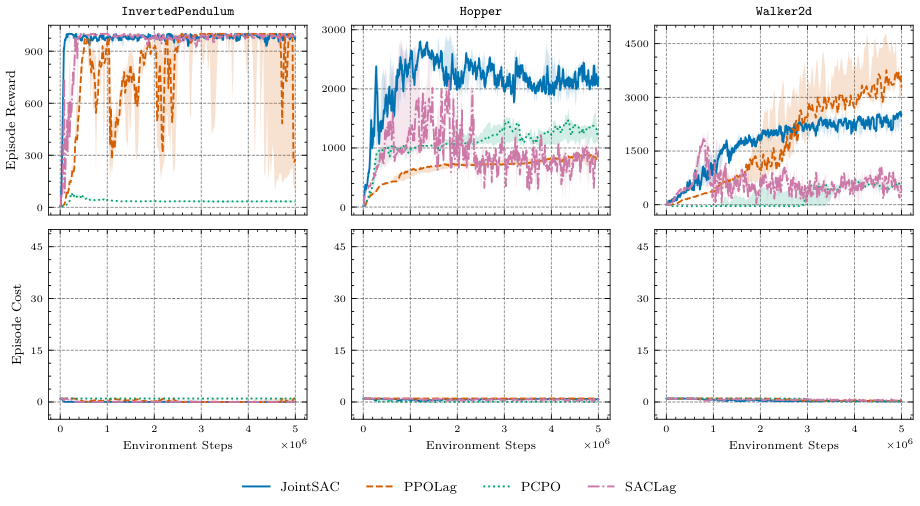
实验设置:MuJoCo 高维连续控制,3 个 Gymnasium 运动环境 + 8 个 SafetyGymnasium 的 SafeVelocity 环境,环境里加了对抗扰动,主动攻击 agent 以迫使其违反安全约束或破坏活性。对比基线包括最宽松安全滤波器(LRSF)和三个 CMDP 基线(PPO-Lag、SAC-Lag、信任域投影的 PCPO)。评测是 5 个训练种子 × 300 次 rollout = 每个环境 1,500 次评估。
| 环境 | JointSAC 回报 ↑ | PCPO 回报 | JointSAC 成本 ↓ | PPO-Lag 成本 |
|---|---|---|---|---|
| Hopper-v4 | 3266.89 ± 103.80 | 1373.82 | 0.03 ± 0.08 | 0.97 |
| InvertedPendulum-v4 | 999.43 ± 1.28 | 34.77 | 0.00 | 1.00 |
| Walker2d-v4 | 2869.59 ± 319.83 | 849.93 | 0.00 | 0.25 |
| SafetyAntVel-v1 | 940.70 ± 9.06 | −2915.70 | 0.00 | 1.03 |
| SafetyHalfCheetahVel-v0 | 1783.42 ± 292.07 | 453.22 | 0.00 | 152.87 |
几处值得单独说:
- SafetyAntVel-v1 上 PCPO 的回报是 −2915.70 ± 2404.71——负到离谱。论文的评语是"PCPO 在 SafetyAntVel 上倒着走"。在对抗扰动下,一个靠投影来保证安全的策略可能为了苟住安全约束而彻底放弃任务目标。这是 CMDP 路线的一个真实失效模式。
- SafetyHalfCheetahVel-v0 上 PPO-Lag 的成本是 152.87 ± 341.14——这不是"平均值偏高",而是有相当一部分回合彻底失控(标准差和均值同量级)。
- JointSAC 的最坏情况是 Hopper-v4 上的 0.03 ± 0.08,其余环境全是 0.00。论文的表述是"11 个环境上违规近乎为零"。
五、一个容易被忽略的机制:安全集扩张
论文附录里有个我觉得比主表更有意思的发现(Figure 3):安全集在训练初期会先朝着高回报的方向扩张,然后才收敛到最大安全集。
这解释了一个此前很少被讨论的问题——为什么很多 safe RL 方法训练早期会"先违规再收敛"?不是优化不稳定,而是算法在主动搜索可行域的边界:早期策略还在试探哪里安全,随着安全 critic 跟上,可行区域被逐步认证并扩大。
这个洞察对工程很实用:如果你的安全 RL 训练早期出现违规尖峰,不一定是超参没调好,可能只是正常的学习过程——但前提是你确实有机制在扩张可行域。
另一个边界条件:论文的 Table 4 扫描了裕度尺度 K 从 200 到 2000,回报总体随 K 上升,但超过某个点后神经近似会引入训练不稳定(在 Walker2d 上可见)。所以 K 不是越大越好。
六、我的判断
这是一篇理论驱动的论文,价值在于它把一个二选一变成了一个可调的连续谱。
- 价值函数层面的耦合值得优先尝试。如果你的安全 RL 训练不稳定(梯度冲突、任务和安全互相抵消),论文给出的处方是换 Bellman 算子,而不是调 Lagrangian 系数。这在工程上的意思是:不要在同一个目标函数里硬塞两个相反的东西,试试把它们在值空间里合并。
- 两时间尺度是这个方法能跑起来的工程关键。安全 critic 必须比任务 critic 学得快,否则联合算子的不动点追不上。实现时优先保证这个时间尺度分离的鲁棒性。
- "对抗扰动"这个评测设定值得抄进你的内部 benchmark。论文加了会主动攻击 agent 的扰动,而不是只测随机扰动。被动扰动下的安全数字没有决策价值——你的策略到底是被动安全,还是被主动攻击时才崩,一测就知道。PCPO 那个 −2915 的回报就是主动扰动逼出来的。
要留意的局限:
- 环境还是 MuJoCo + SafetyGymnasium 级别。高维连续控制 + 对抗扰动是很硬的设定,但这些环境本身的状态空间和动力学复杂度,跟真机或者仿真人形的差距还很大。论文没有真实机器人实验。
- "随时安全"的保证建立在模型精确已知的前提上。理论部分用的是 viability kernel 和 Hamilton-Jacobi 可达性这一套,结论是在给定模型下成立的。用神经网络近似时,实际保证会退化到论文实证的那个"近乎为零"。这是理论保证和工程现实的落差所在,不要过度解读。
- K 的稳定性边界需要自己扫。论文给了 200→2000 的观察,但你的网络规模、任务难度不同,这个转折点会移动。
- 相比 CMDP 基线的优势可能部分来自基线实现质量。PCPO 出现 −2915 这种数字,说明在这套对抗扰动设定下该方法的实现或超参没有调到最佳。公平地说,PPO-Lag 和 SAC-Lag 的表现要正常得多。所以"最好"这个说法应该谨慎对待。
一句话总结:这篇论文最有价值的贡献是提供了一个新基座——如果你正在做 safe RL,"换 Bellman 算子"这个选项值得排在"调 Lagrangian 系数"前面。
参考资料
- 论文:A Unified Bellman Operator for Safety-Critical Reinforcement Learning — Nishanth Arun Rao*、Royina Karegoudra Jayanth、Benjamin Eysenbach、Jaime Fernández Fisac(Princeton University,*同等贡献),arXiv:2610.12420,2026
- 许可:CC BY 4.0(本文引用图均出自该论文并已标注出处)
- 延伸阅读:FAITH: Feasibility-Aware Safety-Filtered RL for High-Dimensional Systems —— 同一问题的另一条路线(模型自由 + 滤波 + 29-DoF 人形真机),可对照阅读