当世界模型只搭骨架:解读 Tencent Proxy2World 的「轻量代理」路线
2026 年 9 月底,Tencent IEG 放出了 Proxy2World(arXiv:2609.35023)。它想回答一个工程上很现实的问题:如果只让你搭一座城堡的骨架(几条低多边形线 + 几个简单几何体),能不能让生成模型自己把墙体、材质、光照全部补出来,而且每一次补出来的还都不一样?答案是可以,而且关键判断是——不要用 proxy–video 配对数据训练。
这篇笔记会拆开 Proxy2World 的方法、为什么「不配对训练」是它的核心赌注、以及它提出的 ProxyBench 给了哪些可量化的对照。然后我会给出工程落地角度的判断——什么时候该抄这条路线,什么时候应该绕开它。
一、问题:让视频模型「听话」的三种姿势
可控视频生成(controllable video generation)走到 2026 年,主流路线其实只有三种摆位,各有取舍:
- 只给相机轨迹(如 CameraCtrl、ViewCrafter):模型自由发挥场景,但只要场景里有几个人物,相机一动人物就容易「飘」。
- 给完整 3D 资产(精细网格 + 材质 + 绑定):控制最准,但单个场景的搭建就是一笔不斐的艺术工时——UGC 场景根本撑不起。
- 给轻量代理(proxy)(低多边形线框 + 简单几何体 + 关键主体占位):用户只声明「城门必须在那个位置、桥必须按这条路径升起」,外观由模型补全。Proxy2World 选的就是第三种。
第三种姿势的关键难度在于:proxy 本身是「underdetermined」的。同一座城堡骨架,可以生成哥特黄昏、神秘紫晶、血色圣殿三种完全不同的世界——这不是 bug,是产品需求。如果用「proxy ↔ 真实视频」配对数据去训练,模型会过度记忆一种渲染风格,反而失去了多样性。
二、方法:没有 proxy–video 配对数据,怎么学结构服从?
Proxy2World 的核心做法是把训练和推理解耦:
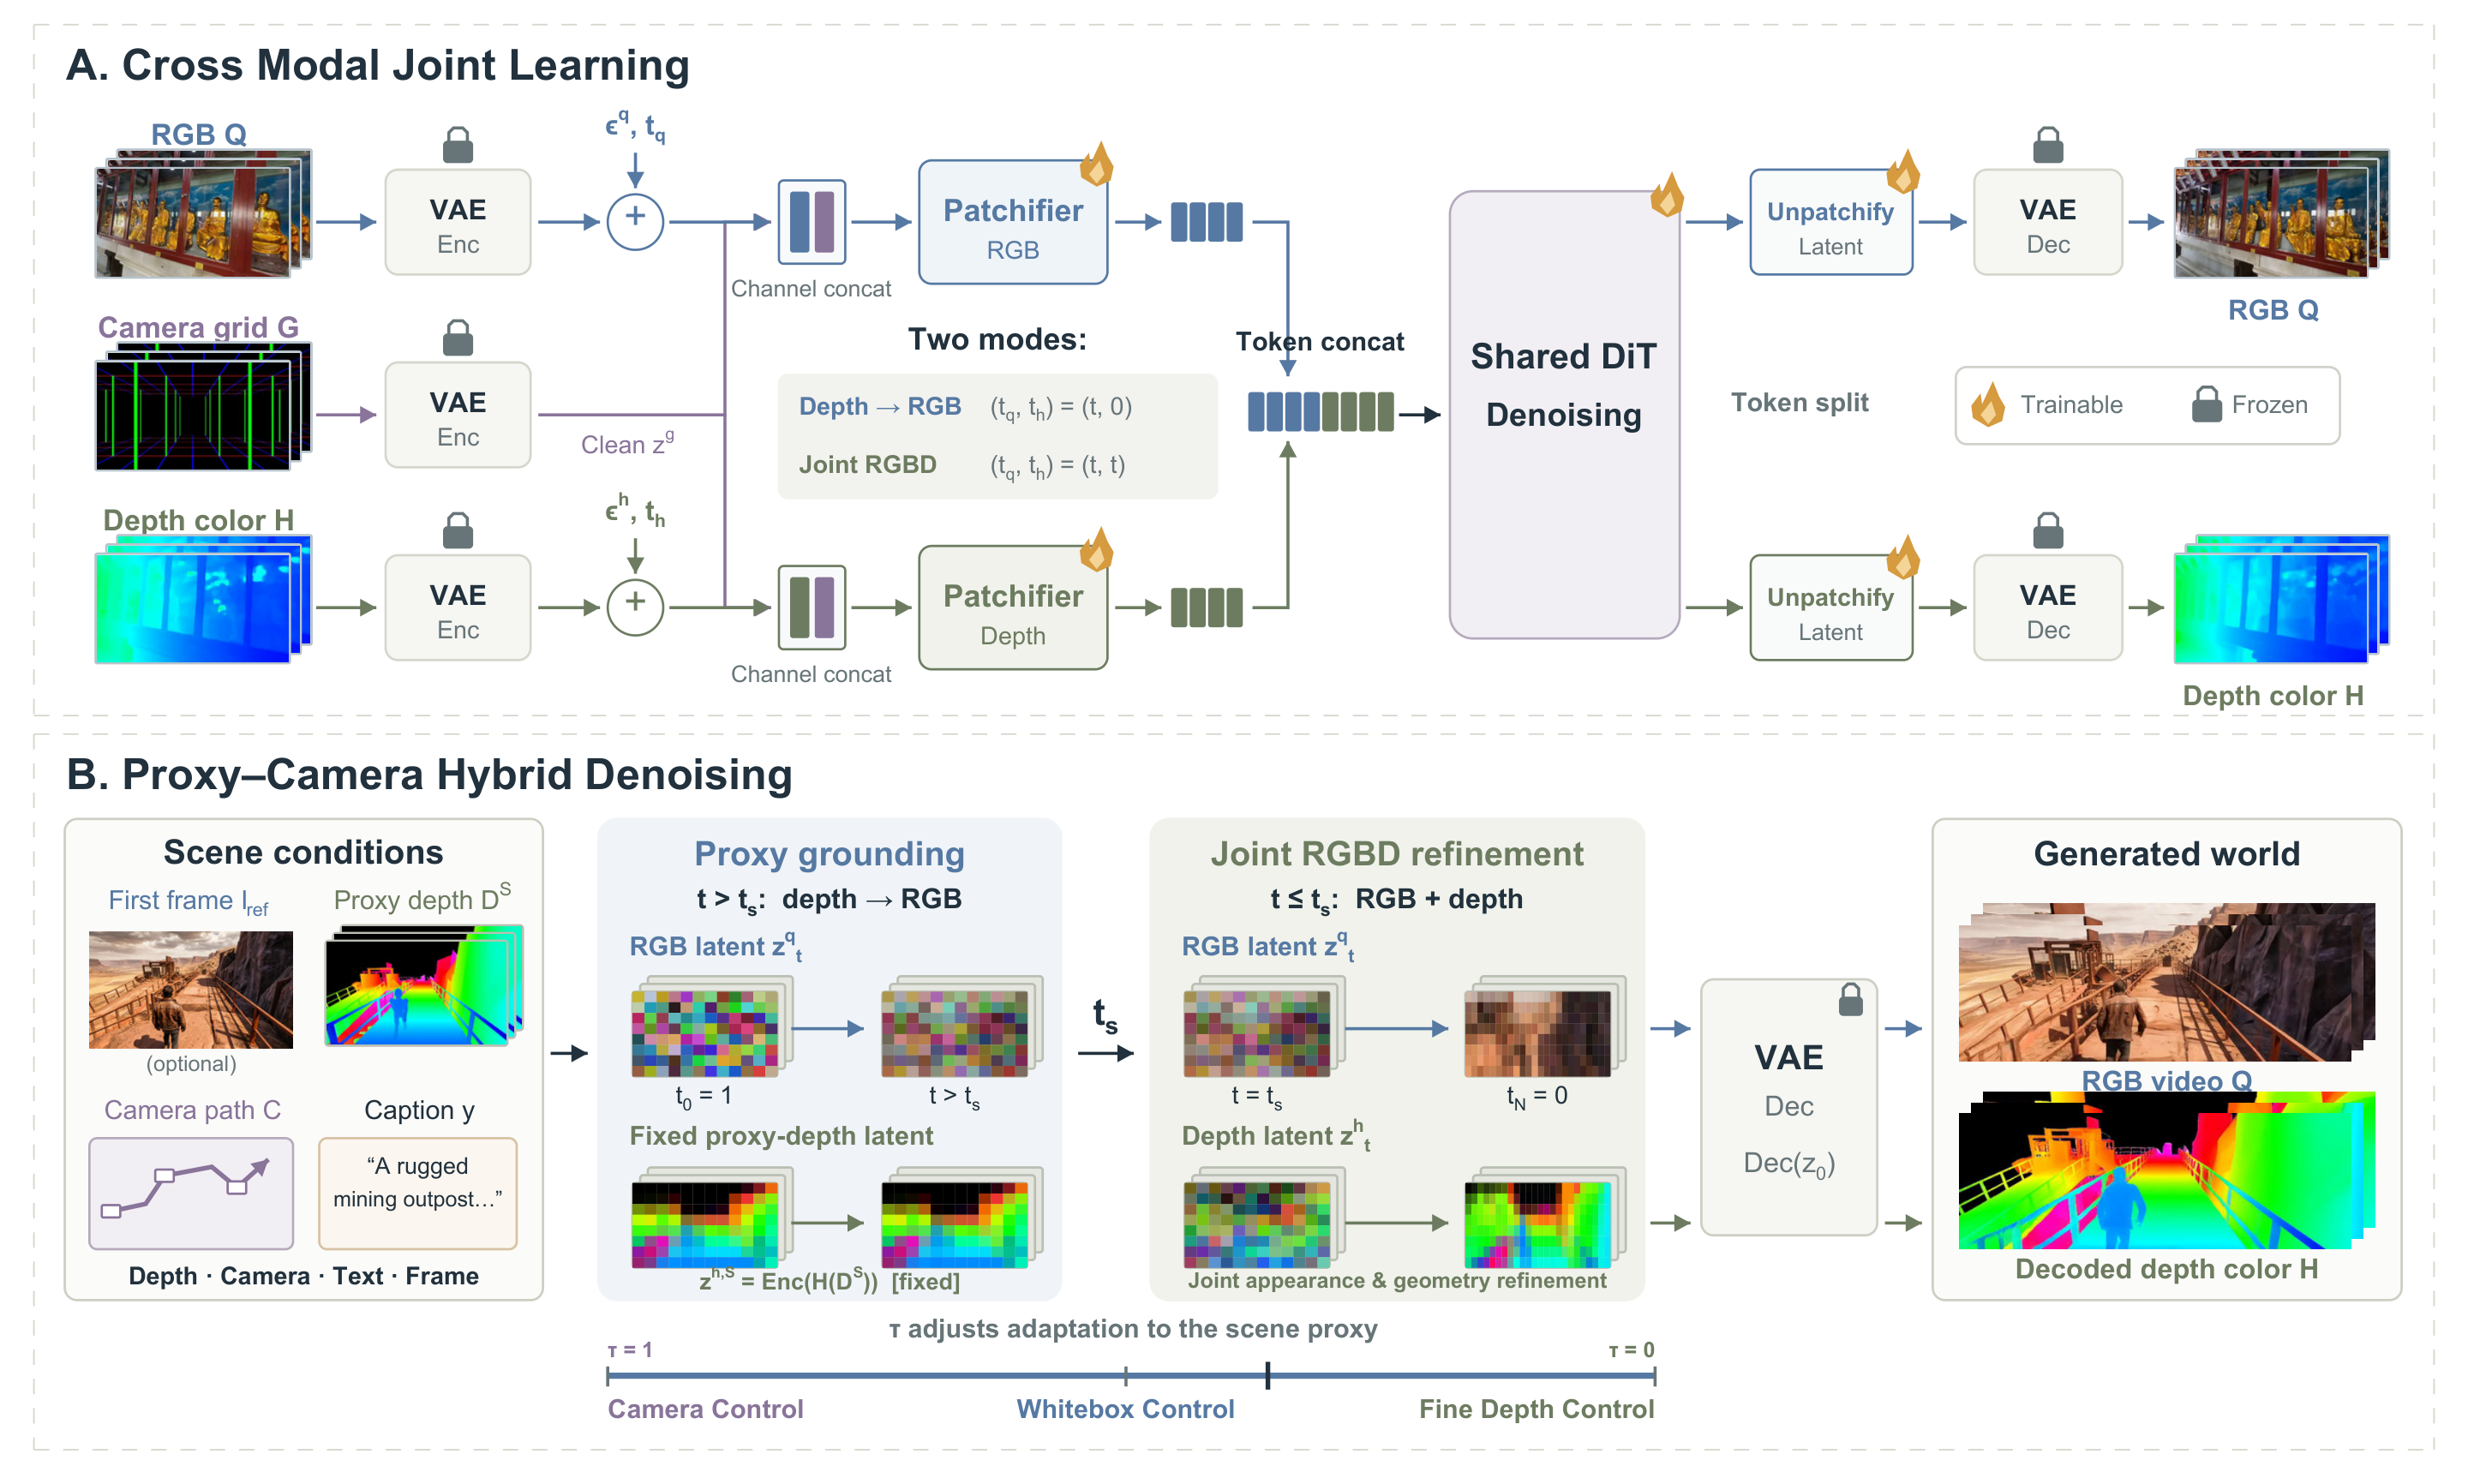
- 训练阶段,只用普通的、带相机位姿的 RGBD 视频(120,624 段),让一个共享的 DiT 同时学两种能力——深度条件下的 RGB 生成(几何当作硬约束)和RGBD 联合去噪(几何与外观一起细化)。这一步用 cross-modal flow matching 串起来。
- 推理阶段,执行一种 40 步的「hybrid denoising」:前 3 步把 proxy 渲染出的深度当作硬条件,强行把场景结构钉死在用户声明的布局上;后 37 步去掉这个深度硬约束,让模型同时细化 RGB 和 深度,但始终保留相机引导。
为什么要分两步?因为如果全程把 proxy 深度当硬条件,模型会原样保留低多边形的僵直边缘;如果全程只用相机引导,主体位置又会偏离设计稿。论文的消融实验(图 5)清楚显示:单一控制都会失真,混合推理是唯一兼顾两者的方案。
另一个不显眼但关键的细节是相机-几何尺度对齐。proxy 的深度图和视频模型期待的深度必须在同一度量尺度上,否则相机一动几何就会「各说各话」。这部分在论文里只占两段,但工程上是最容易翻车的地方。
三、数据:为什么「不配对训练」反而是优势
控制式视频生成的老问题:proxy 千人千面,根本没有自然存在的「proxy ↔ 视频」配对数据集。如果你让设计师手动为每段真实视频反向拆出 proxy,单段成本可能就要几小时;自动化又会把「我想要的 proxy」和「模型看到的 proxy」混淆。
Proxy2World 的策略是不训练这个映射,而是让模型从普通 RGBD 视频里学到「几何是一种可以被遵守、也可以被放开的条件」。结果是:
- 训练时只需要相机位姿 + RGBD,不依赖任何 proxy 标注。
- 推理时用户提供的 proxy 越粗糙,模型越能补全;越精细,模型越会服从。
- 同一组 proxy 权重,可以渲染出多种完全不同的视觉风格——这恰恰是 UGC 平台想要的。
我个人最喜欢的一个 demo 是「同一个城堡骨架」下切换 Gothic / Arcane / Crimson 三套配色,相机和动作完全一致,但场景气质完全变了。代理做约束、模型做自由度,这种分工对内容生产是真有用的。
四、评测:ProxyBench 给了哪些可比的数字
为了避免「自说自话」,论文同时放出了 ProxyBench(25 个场景、300+ 段 5 秒序列,论文里选 78 段做统一定量比较)。它的核心论点是:可控视频生成不能只看「几何对齐」或「相机误差」一项,必须同时看结构服从、外观质量、相机精度——它们之间天然存在 tradeoff。
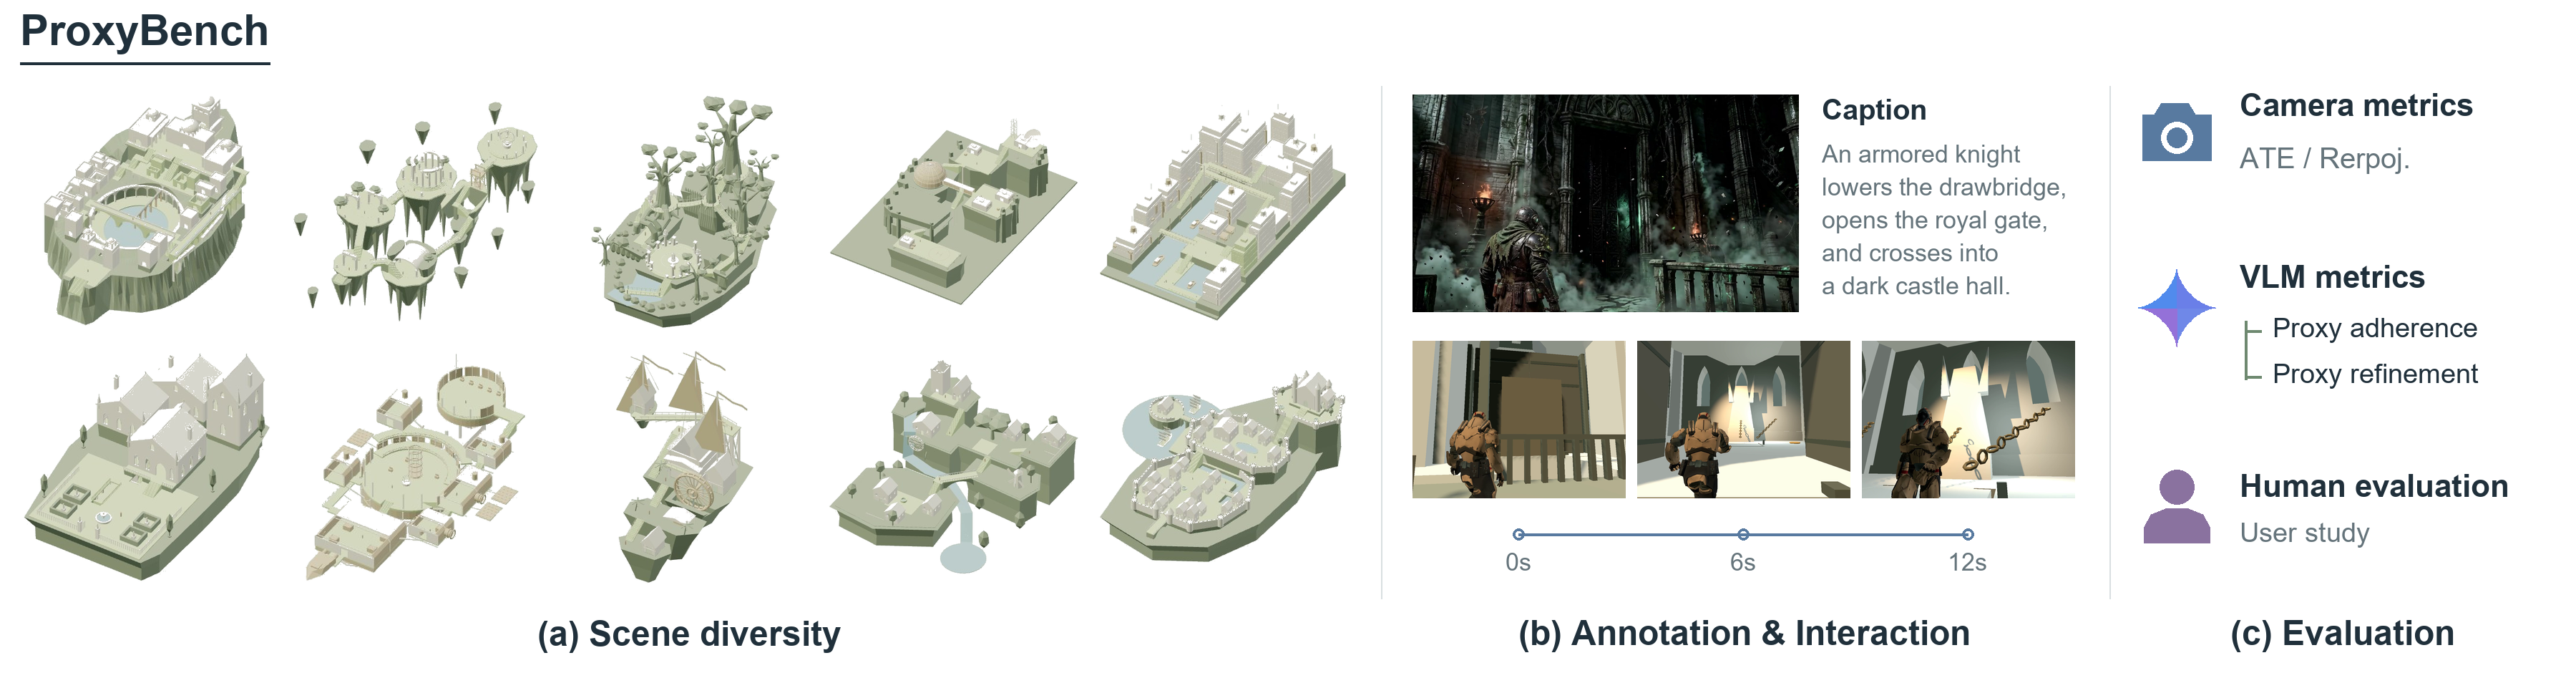
论文给出的代表性数字(同一权重、同样的文字 + 首帧 + 相机轨迹输入):
- 加入代理混合控制后,几何对齐分数从 0.5340 → 0.6795(+27.2%)。
- VLM 评估的代理遵循胜率 53.55% → 64.18%,细节精修胜率 71.44% → 77.96%(两两比较、半胜计算)。
- 在「文字 + 相机 + 代理、不用首帧」配置下,相比 Coarse2Real,归一化位移误差降低 47.3%、旋转误差降低 77.2%、几何对齐提升 28.3%。
值得提醒的是,论文自己也承认不是所有指标都第一。例如 Cosmos-Depth 在 VLM 代理遵循胜率上反而高于混合版本。论文的重点是「在保留可控结构的同时让粗糙几何有机会变成更自然的形体和外观」——这是一个tradeoff 优化,不是单点冠军。
五、我的判断:这条路线值不值得抄?
看完方法、数据和数字,我的工程视角判断如下:
什么时候该走 Proxy2World 路线
- UGC / 互动叙事 / 关卡设计:你需要一个「低保真但可玩」的体验闭环,玩家要快速看到自己的 proxy 长成什么样子。这种场景下 Proxy2World 的多样性优势最大。
- 仿真数据生成:机器人或自动驾驶需要大量「结构可控、视觉多样化」的合成视频,proxy 作为可控锚点比纯文本提示稳定得多。
- 已有大规模 RGBD 训练数据:如果你公司内部有现成的 RGBD 流(如游戏引擎、3D 扫描),这条路线几乎白嫖。
什么时候不该走
- 只做短视频、单镜头、低多样性需求:纯 CameraCtrl 加首帧就够用了,多花一套 proxy pipeline 不划算。
- 需要严格像素级一致性:proxy 给的是「结构服从」,不是「像素服从」。如果客户要的是「同一段视频里角色必须像素一致」,目前所有可控生成方案都还撑不住,需要走 3D Gaussian / NeRF 这条重建路线。
- 训练数据全是 2D、没有 RGBD:Proxy2World 的方法核心是 RGBD 跨模态学习。如果你手上只有 2D 视频,需要额外接深度估计模型,质量会打折扣。
两条延伸观察
- 「混合推理 + 多模态条件」正在变成可控生成的默认配方。Proxy2World、4Director、LooseControlVideo 这一波新工作,几乎都是「前 N 步硬约束 + 后 M 步放开」的混合控制思路。可以赌一把:未来 12 个月,所有顶会视频生成论文都会引入这种 timestep-wise 强度调节。
- benchmark 比模型更值得抄。ProxyBench 这种「结构 / 质量 / 交互三者联合评测」的范式,比单点冠军论文更影响行业——它直接决定了下游团队如何选模型。如果你正在搭内部评测,强烈建议抄它的指标设计思路。
六、落地思考:现在可以拿这套方法做什么
如果你下周就要在公司内部复现或借鉴这条路线,我的建议是:
- 先确认你手上的 RGBD 数据规模。没有 10 万+ 段带位姿的 RGBD 视频,跨模态 flow matching 学不出来。
- proxy 渲染管线可以现搭:Blender + 自定义 USD 输出 + 一个简单的 ORB-SLAM 风格的相机跟踪,一周能跑通。
- 推理的 hybrid schedule 是个性价比最高的工程改造——把现有扩散模型的早期 timestep 替换为「结构条件硬约束 + 后段放开」,改动几十行代码就能拿到 20%+ 的几何对齐提升。
- 评测建议直接用 ProxyBench 的设计骨架:5 个结构服从样本 + 5 个外观质量样本 + 5 个相机精度样本,每个跑 10 次取中位数。
参考
- 论文:Xu, H., Yan, W., Wang, A., Zou, C., Hong, S., Huang, J. Proxy2World: Learning to Generate Worlds From Lightweight Proxies without Seeing Them. arXiv:2609.35023, 2026. arXiv
- 项目页(含视频 demo、UGC 体验):https://dumdumgura.github.io/proxy2world/
- 代码仓库(占位 Coming Soon):github.com/dumdumgura/proxy2world
- 许可:本文两张图均来自官方项目页,论文与项目页均以 CC-BY 4.0 授权使用。
下一篇预告:当世界模型进入「在线任务识别」阶段,机器人该如何看待自己的「预演未来」能力——以及为什么这会改变具身智能的训练循环。