把动作写成语言:拆解 LaLa-World 的世界模型统一接口
世界模型这件事,难点从来不是"能不能预测下一帧",而是能不能用一个模型吃下所有数据源。LaLa-World(NAVER AI Lab 等,2026)给出了一个我认为是目前最工程友好的答案:把数值动作和视觉变化都写成自然语言,让语言成为跨域的统一接口。一个模型同时吃仿真轨迹、机器人轨迹和普通视频,规划性能比 RAEv2 这样的生成式世界模型还高,训练成本却只有 1/6。
这篇拆解三件事:为什么"用语言描述动作"这件事比听起来更有效,13.9× 的规划加速从哪来,以及这套设计什么时候会失效。
一、问题出在动作空间的异构性上
先把问题定义收紧。JEPA 风格的 latent world model(LWM)——比如 V-JEPA 2-AC、DINO-WM——优势很明确:不做像素重建,只预测表征怎么变,所以想象一次 rollout 的成本极低。这是 MPC 能在真实机器人上跑起来的前提。
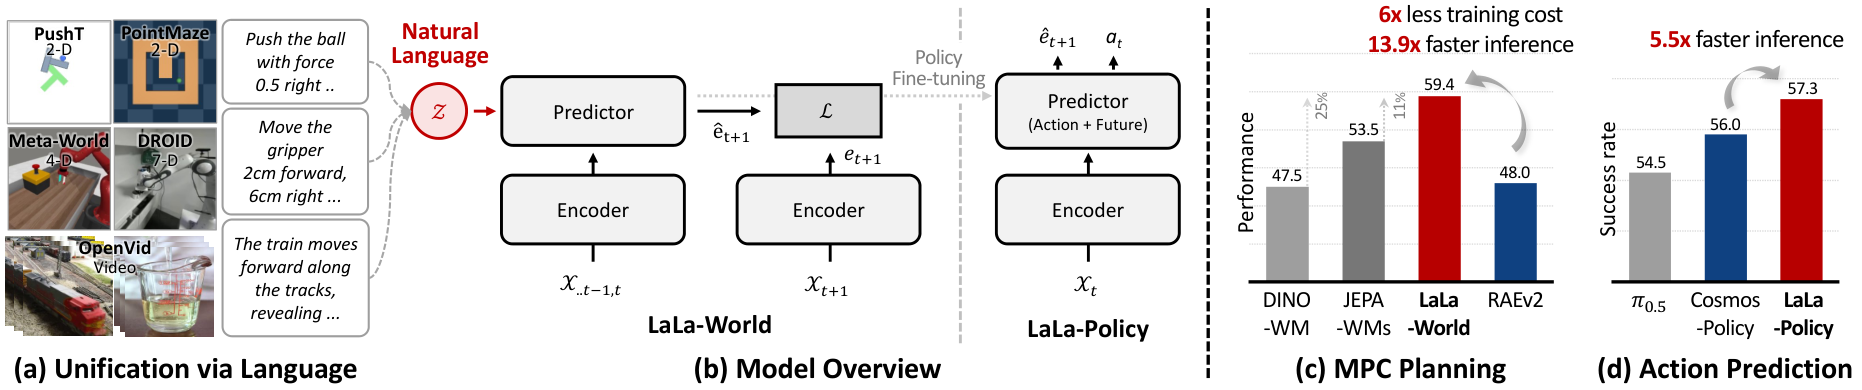
但这类模型的 action-conditioned predictor 基本只在仿真或机器人数据上训过,而数值动作是强域相关的。同一个 [2,4],在某个域里是水平/垂直位移,在另一个域里是力;PushT 的 2 维、PointMaze 的 2 维、Meta-World 的 4 维、DROID 的 7 维,物理含义完全不一致。要让一个共享 predictor 学到共享动力学,接口就必须先统一。
更麻烦的是另一半:互联网图像和视频数据量最大,却没有动作标注。它恰好是最缺"世界如何随动作变化"这一监督信号的数据源,所以以往只能拿来做视觉预训练,没法喂给世界模型的预测器。
这两个问题指向同一个解:需要一个既能表达数值动作、又能表达视觉变化的统一接口,而且这个接口要能在没有动作标注的数据上"说得出来"。
二、核心设计:用语言当中间层
LaLa-World 的做法分两步,都很朴素,但朴素得恰到好处。
第一步,动作描述成句子。仿真/机器人的数值动作被转成自然语言,比如 move 2 left and 4 up、push with force 2 downward;而普通视频数据里的视觉变化,用另一类语言描述,比如 the train moves forward along the tracks, revealing ...。两类数据于是进入同一个文本接口,可以混合训练同一个未来预测器。
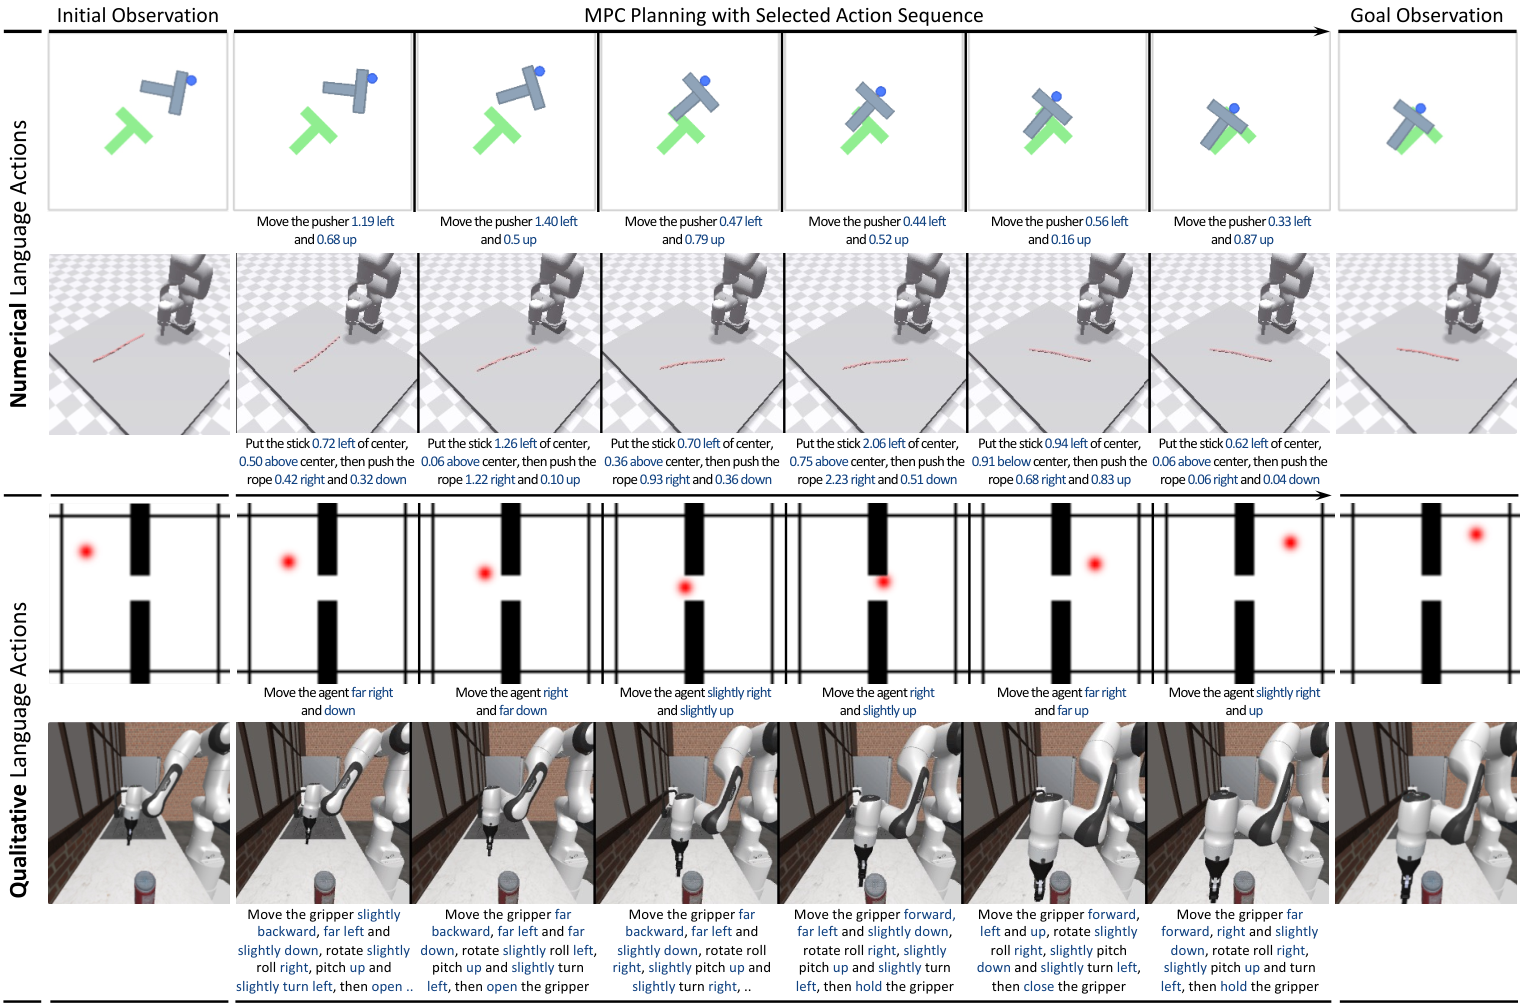
第二步,预测器本身建在语言模型上。这不是"加个文本编码器"的程度——预测器主干就是一个 LM,所以它天然能理解"往左 2"和"稍微往左一点"这两种描述,并把它们映射到不同的潜在未来。这里有个漂亮的副作用:模型可以接住没有数值动作的纯定性指令,比如 move slightly left,规划器照样能工作。论文里专门展示了这一能力。
三、数字:13.9× 从哪里来
论文给了三组关键对比,都值得抄下来当自己的验收标准。
3.1 MPC 规划性能
同一个联合训练的预测器 vs. 各个域单独训练的 LWM baseline vs. 生成式世界模型 baseline(RAEv2):
| 方法 | MPC 规划性能 |
|---|---|
| DINO-WM(单独训练) | 47.5 |
| JEPA-WMs(单独训练) | 53.5 |
| RAEv2(生成式世界模型) | 48.0 |
| LaLa-World(联合训练) | 59.4 |
注意增益的两个来源:一个是"联合训练 > 分域训练",另一个是"latent > generative"。前者说明共享接口确实让跨域数据互相受益了;后者说明在规划这个任务上,不必重建像素这件事本身就是巨大的工程优势。
和 RAEv2 的匹配对比更狠:相同的语言条件、相同的训练数据、相同的视觉编码器,LaLa-World 训练成本低 6×,规划快 13.9×。原因很直白——RAEv2 的预测器是 diffusion Transformer,每一步要去噪;LaLa-World 的预测器是一次前向出潜在状态。规划要在 MPC 里反复评估候选动作序列,这个差距会被乘上去。
3.2 加视频数据的收益
论文明确报告:加入图像和视频数据后,平均规划性能进一步提升,且对动作措辞的鲁棒性明显增强。后者尤其有价值——"往左 2"和"往左边挪一点点"在向量空间里是无关的两个点,但在语言模型的语义空间里挨得很近。
3.3 LaLa-Policy:世界模型当预训练
预训练好的 LaLa-World 可以微调成 LaLa-Policy,同时预测动作和未来视觉表征。在 LIBERO 和 RoboCasa 上和 Cosmos Policy 对比:π0.5 成功率 54.5、Cosmos-Policy 56.0、LaLa-Policy 57.3,同时单条轨迹平均推理时间降低 5.5×。
四、我的判断
值得抄的三件事:
- 接口设计优先于模型规模。这篇的核心贡献不是某个新模块,而是"用什么语言描述动作"这个接口决策。工程上这意味着:如果你手里有多个异构数据源,第一个要做的不是换更大的 backbone,而是先设计好它们之间的公共语言。这一条在任何多域学习场景都成立。
- LM 当世界模型主干是被低估的选项。LM 主干带来的不只是"能读懂文本",还有语义空间对措辞扰动的平滑性——这对需要人机交互的机器人场景是刚需,因为人下达的指令本来就不精确。
- Latent 路线在"要想象很多次"的场景下几乎必然赢。13.9× 不是优化出来的常数,而是架构决定的量级差异。如果你只生成一次视频,生成式模型更香;如果你要在真机上做 MPC 搜索 50 条候选轨迹,延迟差会被放大成能不能落地的问题。
要留意的三个坑:
- 语言是有损压缩。"move 2 left" 里的 2 是精确量,但一旦进入 LM 的语义空间,连续量的精度就受限于 token 化与上下文。论文没有系统讨论这个精度天花板,但从图 1(c) 看,LaLa-World 相对单独训练的 JEPA-WMs 有 +25%、+11% 的增益,说明接口带来的收益盖过了损失——但换到需要亚毫米精度或者力控的场景,这笔账要重新算。
- 额外数据是调味料不是主菜。加视频数据提升的是平均性能和措辞鲁棒性,不是数量级。指望靠"多喂点互联网数据"把某个具体任务从 40% 干到 80%,不现实。
- 代码开放但要评估复现成本。项目页和代码都在 GitHub 上(junha1125/LaLa-World),但训练数据混合策略和 LM 主干的规模选择都需要自己试。建议先在自己的两个域上验证"联合训练 > 分域训练"这个假设是否成立,再决定要不要投入全量混合训练——这一步能省掉大部分算力浪费。
一句话总结:LaLa-World 证明了一件工程上很值钱的事——世界模型的"通用性"瓶颈往往不在模型,在接口。把动作写成语言这个动作,看起来简单,但它把"能不能统一"从一个模型问题降维成了一个数据结构问题。
参考资料
- 论文:LaLa-World: Scaling Latent World Models with Natural Language Actions — Junha Song, Geonmo Gu, Jeongeun Park, Heejeong Nam, Lucas Maes, Byeongho Heo, Dongyoon Han, Sangdoo Yun(NAVER AI Lab / Georgia Institute of Technology / Brown University / Mila & Université de Montréal),arXiv:2610.27851,2026
- 项目页:https://june-page.github.io/lala-world/
- 代码:https://github.com/junha1125/LaLa-World
- 许可:CC BY 4.0(本文引用图均出自该论文并已标注出处)