今日 6 篇 arXiv 速读:GlobeBench 让 20 个模型在「后果要传播到依赖对象」时集体掉到 5.1%、Latent WAM 把 GUI 世界模型从像素搬到潜空间、WorldCast 用深度点云撑住大角度运镜、VLA-Stem 给冻结的 VLA 套一层只管避障的反射弧、RECREG 把「安全」写成整条轨迹的正则性质、DynaFlow 让主 agent 自己写协作程序
昨天(10-28)那篇的落点是「均匀对待」:每个领域的默认做法都建立在「所有东西都同等重要」之上,解法是找出那个不均匀的地方,然后给它加权。那篇结尾我自己留了个问题没回答:「不均匀」这件事该由谁说了算。
今天这 6 篇正面处理这个问题,而且处理方式高度一致 —— 全部都是「代理目标和真实目标错位」。你用来打分的东西不是你真正在乎的东西;而你按那个代理目标做的优化,会把系统朝着一个错误的地方推。今天的 6 篇,每篇都在处理这个错位的一个具体变体:
- GlobeBench:文本世界模型的判分标准 —— 拿「下一步描述像不像」当尺子,测出来的却不是世界模型能力;
- Latent WAM:像素重建当尺子,模型学会了「保持现状」这条捷径;
- WorldCast:相机轨迹误差当尺子,角色换脸了也看不见;
- VLA-Stem:动作 chunk 当尺子,逐时刻对齐反而把碰撞招来了;
- RECREG:「当前状态安不安全」当尺子,非马尔可夫的安全性质根本测不出来;
- DynaFlow:最终答案对不对当尺子,协作过程烂透了照样得分。
下面这张图把 6 篇放到两轴上。横轴是换判据要动到系统的哪一层(从左到右:只换评测口径 → 换训练目标 → 换执行逻辑本身);纵轴是真实目标由谁定义 —— 最上面是环境执行记录自己给出,中间是模型内部的信号,最下面是人或形式化规范写死。这张图想说的其实是一句话:越往下,越有硬保证,但越需要你先想清楚自己要什么。
一、GlobeBench(Saban、Bannur、Vasileva、Deshpande,arXiv:2610.22708,Patronus AI,cs.AI / cs.CL,2026-10-15,CC BY 4.0):把尺子本身重造一遍,才发现「像」和「对」不是一回事
问题:文本世界模型(Text-based World Model)最近被看好,用来模拟 RL 环境的状态转移、支撑可扩展环境仿真。但没有一个标准化的基准来比较、研究、改进它们。
关键 idea:GlobeBench —— 1,632 个任务,横跨 5 个领域、19 种仿真技能。每个任务问的是同一件事:给定完整 agent 轨迹,模型能否预测环境对某个具体动作的响应。要答对,模型得理解三件事:更早的状态发生了什么变化、环境规则是什么、这个动作对相关对象和无关对象分别有什么影响。判分方式是混合架构:确定性闸门 + 语义 judge,比对的参照物是从真实执行记录导出的 reference —— 也就是说,「正确答案」来自实际跑一遍环境,不是人写的。
数据 / 数字:拿 20 个通用 LLM + 专门的文本世界模型一起测:GPT-6 Astra 最高,任务成功率 49.57%。论文里最有信息量的两个数字是:
- 动作影响范围越大,准确率越低。而当 agent 的改动必须传播到依赖对象时,20 个模型的平均任务成功率掉到 5.1%。
- 631 个任务没有任何一个模型解出来 —— 论文的解读是:通用 LLM 当世界模型,离「能用」还有明显距离。
为什么这个 5.1% 值得停一下:它不是「模型不够强」的那种失败。上面两段任务里,模型大概率都能写出看起来非常合理的下一步描述 —— 门开了、灯亮了、东西掉了。挂掉的是那些必须说清楚「因此,那个依赖它的东西也变了」的任务。也就是说,模型学到的不是后果,是表面连贯性。拿「下一步描述像不像」当尺子,测出来的是流畅度,不是世界模型能力。
工程判断:
- 什么时候抄:抄判分方式,不抄任务本身。最值得搬的是那个「确定性闸门 + 语义 judge」的混合架构,以及用真实执行记录导出 reference这个思路 —— 这直接解决了「谁来定义正确答案」这个死结。你的世界模型如果连自己都说服不了,那是尺子的问题。代价是要有环境能跑出真实执行轨迹。
- 什么时候不抄:你的环境跑不出参考轨迹(比如纯文本推理、或者环境本身没有可执行接口),那这个基准的形式就用不了,只能借它的问题设计:去找那些「后果要传播到依赖对象」的任务,自己造一组,看模型会不会在简单任务上很行、一到传播就塌。
- 一句话启发:「看起来合理」和「推得对」之间隔着一整个依赖图。」任何拿模型输出和参考答案做相似度匹配的世界模型评测,测的都是流畅度。
二、Latent World Action Model for GUI Agents(Yu、Choi、Park、Shin、Shim,arXiv:2610.14228,KAIST,cs.CV / cs.AI / cs.HC,2026-10-09,CC BY 4.0):像素重建当尺子,模型学会了「什么都不变」
问题:GUI agent 的像素空间世界模型走的是「先预测未来屏幕,执行后再重新感知」这条路。两个硬伤:(L1) 像素重建的计算开销;(L2) 需要重建大量动作选择根本用不上的外观细节。更要命的是第三点 —— 论文叫它 identity shortcut(恒等捷径):屏幕生成目标会诱导模型「保持现状」,未来状态预测基本在复制当前画面,而不是捕捉动作诱发的变化。
关键 idea:把预测目标从全屏重建换成动作诱发的未来信息,而且换到潜空间里。用一个大型多模态模型当潜世界模型,共享表征上挂两个头:动作头直接出候选动作打分,转移头负责捕捉动作条件下的未来。为了压住恒等捷径,再加一个动作感知的对比目标,逼转移表征去捕捉「这个动作引起的、有判别力的变化」。推理期还多一道闸门:候选动作置信度高就直接执行,低才叫世界模型出来重排。
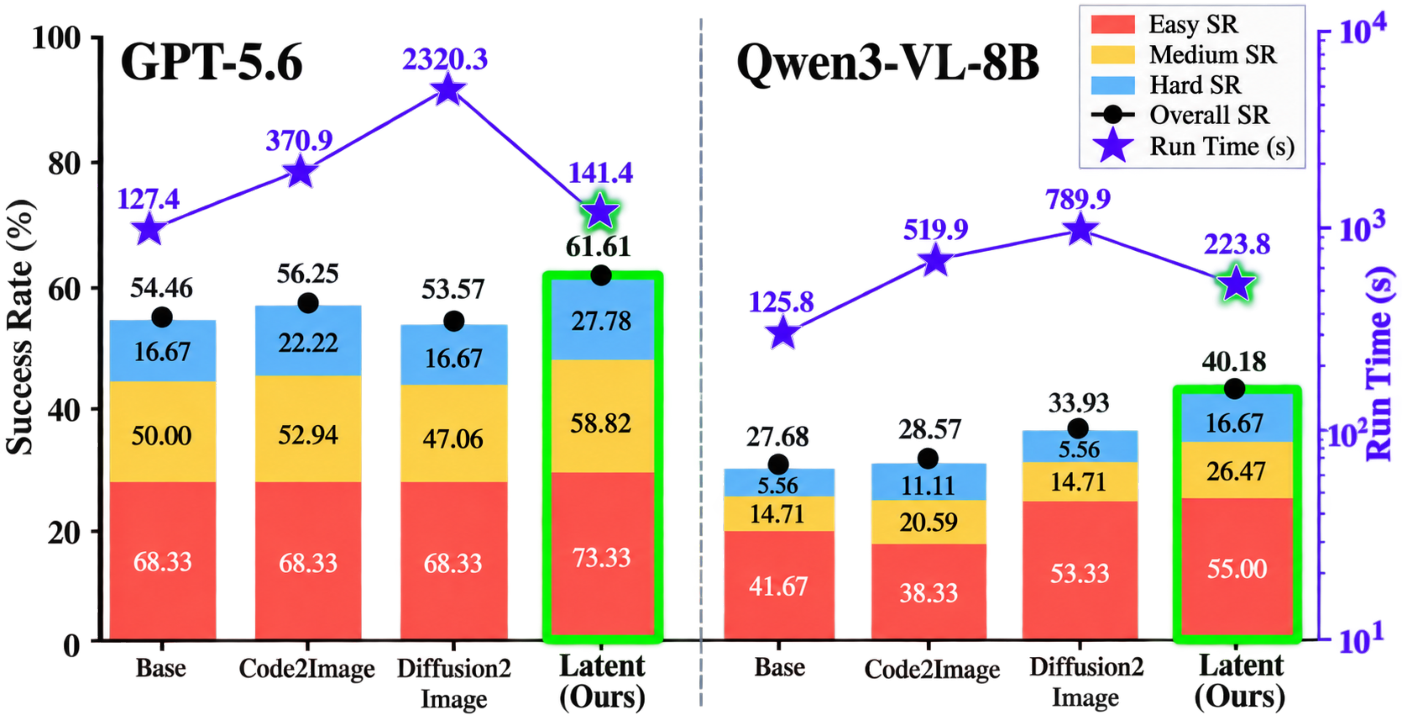
数据 / 数字:相对像素空间世界模型,离线成功率最高 +31.9%、在线最高 +40.6%(相对提升);相对完全不用世界模型的 base agent,离线最高 +11.6%、在线最高 +47.0%;世界模型推理延迟最多降 98.9%。AndroidWorld 在线评测上五个 backbone 全部拿到最高 Overall SR。
还有一个比主结果更狠的数字:在 GUI-Odyssey 这个跨应用、长视野的 OOD 基准上,两个像素空间世界模型的 SR 双双掉到 base agent 以下 —— 也就是说,像素世界模型在分布外不只是没用,是有害的;而潜空间版本仍然保持在 base agent 之上。这个「OOD 下反而拖后腿」的观察,是「像素重建当尺子」这件事最直接的账单。
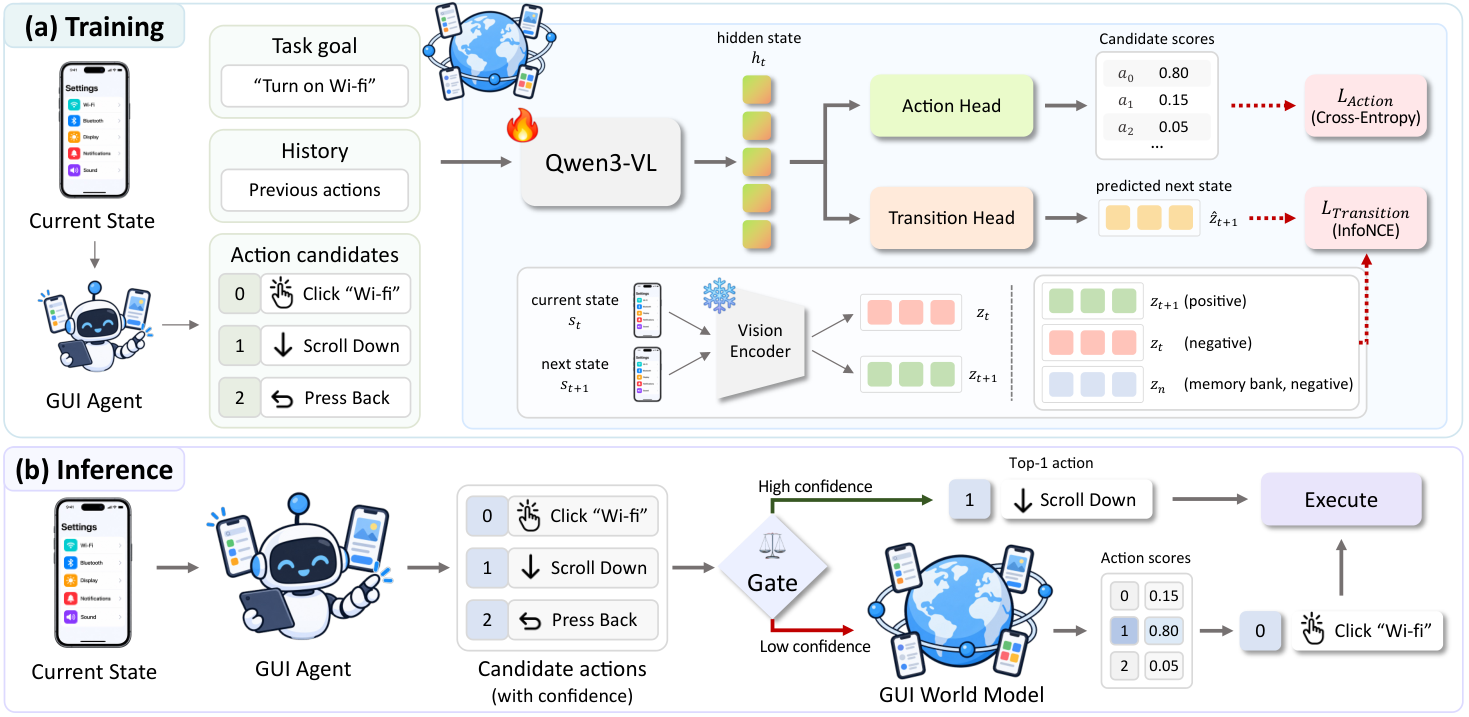
消融是这篇最有说服力的部分:AndroidWorld 上四组递进 —— 纯 base agent → 加动作头 → 再加转移头(用逐点余弦回归训)→ 最后把逐点匹配换成动作感知对比目标。每一级都在涨,而最后一级的收益恰好来自「显式区分动作诱发的未来、当前状态、以及其它竞争未来」。这说明对比目标不是花架子,它在解决一个具体的捷径问题。
三句诚实话:其一,Type(动作类型)的提升比 Grounding(坐标)一致得多 —— 重排机制改的是「选哪个候选」,并不细化候选自己的坐标,所以动作选对了不代表点得准。其二,论文自己报告:最终 token 的表征在残差分析下并不区分动作类型,能分开的是转移头的输出 —— 这是一个对自己方法不利但被写出来的限定。其三,算力不便宜:8 张 RTX A6000,训练每卡约 31 GiB 显存。
工程判断:
- 什么时候抄:你在做「先预测再决策」的两段式 agent,并且发现世界模型「预测得很像但决策没变好」。最小动作是把像素损失换成一个判别式目标 —— 不一定非得潜空间,关键是让损失里出现「动作引起的变化」这个量,再配上「当前状态」和「其它未来」当负样本。这一步的收益在本篇里是 +31.9%/+40.6% 这个量级,而且推理期还省了 98.9%。
- 什么时候不抄:你的世界模型本来就是像素模型,而且下游只需要画面本身(比如给人看的预览、或者渲染任务)—— 那「不要重建像素」直接把你的产出删了。另外要注意这条路的隐性成本:潜空间的世界模型更难审计。你看到的是一串向量,不是一张可以肉眼检查的图,出了问题很难定位。这在安全相关的场景里是实打实的代价。
- 一句话启发:「如果你的世界模型预测出来的未来和现在一模一样,那它可能不是在预测,而是在偷懒。」
三、WorldCast(Cao、Liu、Liao、Zhang、Wang、Zhang、Le、Zhou、Luan、Ma,arXiv:2610.33135,武汉大学 / 小米 MiLM Plus 等,cs.CV,2026-10-23):相机轨迹跟得再准,角色换脸了也算失败
问题:电影感的角色视频生成需要精确的相机控制,但现有方法在大角度轨迹(旋转、平移、半径变化叠加,且起始方位任意)上会失手。更棘手的是:视角一变,初始帧里根本没露出来的角色区域就暴露了 —— 于是几何畸变、外观退化、身份漂移一起冒出来。
关键 idea:两件事一起做。第一,建 CLACT 数据集与基准:角色中心、多视角、带精确相机几何的大角度轨迹;训练语料由 UE5 相机运动序列 + Blender 渲染两部分组成,带多视角角色锚点观测。第二,做 WorldCast:
- 用估计深度把初始帧反投影成 3D 彩色点云,把点云尺度与目标相机轨迹对齐,沿轨迹渲染一遍 —— 得到显式的几何引导和覆盖率掩码;
- 覆盖率掩码的意义很实在:点云没覆盖到的区域,是生成器需要自己补的部分。这一步等于把「哪里是观测到的、哪里是我在猜」显式画了出来;
- GAMA(Geometry-Aligned Memory Attention):用初始帧与多视角角色锚点联合估计相对相机位姿,把锚点几何和目标视角几何表达在同一个坐标系里,再用这个几何对齐去指导「检索并注入视角相关的角色特征」。
数据 / 数字:在 CLACT 上,WorldCast ATE 0.065,次优是 Uni3C 的 0.098(GEN3C 0.130、MVGenMaster 0.125、CameraAnything 0.244、ViewCrafter 0.353、CamI2V 0.351)。身份侧 ArcFace 0.555,最强基线是 GEN3C 的 0.433(DepthDirector 0.423、Lyra 2.0 0.394)。
消融把「谁在起作用」说得很清楚:去掉 GAMA,ATE 从 0.065 退到 0.100、ArcFace 从 0.555 崩到 0.370 —— 记忆检索才是身份的支柱;去掉锚点几何对齐,ATE 几乎不变(0.071),但 RRE 从 0.896 涨到 1.374,而身份保持得还不错(0.547) —— 这正好对应「轨迹对但人不对」;去掉锚点掩码,三项全降。数据侧也有硬依赖:去掉 UE5 数据,ATE 从 0.100 退到 0.359;去掉 Plücker 相机条件,退到 0.275。
一句必须说的实话:图像质量(IQ)这一项 WorldCast 不是第一 —— 0.719,而 Lyra 2.0 是 0.725。它赢在轨迹与身份,不在画质。这跟论文自己的定位一致(这是一个「世界一致的角色视频生成」问题,不是画质竞赛),但引用时别把它说成全面领先。
工程判断:
- 什么时候抄:你做的是条件视频生成,而你的条件里有一部分是几何/位姿。这篇最值得抄的其实不是方法,是那个覆盖率掩码的思路 —— 显式告诉模型「哪些区域没有观测,不要假装知道」。这个做法可以平移到任何「从单帧生成多视角」的任务上,成本极低,收益是把「幻觉」和「推理」区分开。另外值得抄的是评测方式:轨迹误差和身份相似度必须分开报。
- 什么时候不抄:你的任务不涉及大角度变化,或者你没有多视角锚点可用 —— 那 GAMA 这一支整个不成立,而剩下的深度反投影那部分,收益要重新验证(这篇的数据里,去掉 UE5 数据 ATE 直接退到 0.359,说明几何方案对数据来源很敏感)。另外这篇的训练语料是合成的(UE5 + Blender + 真实采集的多视角锚点),如果没有能力搭这套管线,整篇的复现成本会非常高。
- 一句话启发:「轨迹误差和身份相似度是两个指标,合成一个分数就等于让模型只优化其中一个。」
四、VLA-Stem(Zou、Yu、Li、Lin、Ye、Geng、Yu、Zhang、Ji,arXiv:2610.37378,中国科学技术大学 / 澳门大学,cs.RO,2026-10-27):别再逐时刻对齐了,保空间意图就行
问题:现在的 VLA 大多针对无约束环境下的静态操作,忽略空间约束和动态障碍。用避障数据微调 VLA 是个直接办法,但采集贵(动态场景尤其贵),而且可能把原本的任务能力一起搞坏。
关键 idea:VLA-Stem —— 一个「脑干」式的轻量安全机制,关键是完全不动底座 VLA。它把 VLA 输出的 action chunk 转成一条运动参考(motion reference),然后用一个独立的 Stem 策略去执行这条参考。关键在轨迹级引导:保空间意图,放松时间对齐 —— 衡量偏离时,不按固定时间索引去对齐,而是按参考轨迹的局部片段(segment)去对齐,并约束匹配只能往前走。于是 Stem 有空间自由度去躲障碍,但不能把「意图方向」搞丢。
训练:teacher-student 蒸馏 + 课程学习。teacher 在训练时能用特权信息(目标物体的信息)加速学习,蒸馏出的 student 部署时不需要特权信息。课程三段:无障碍跟随参考 → 静态空间约束 → 动态障碍,各阶段预算约 38.0M / 23.7M / 20.6M 仿真转移每 seed。奖励是任务完成 + 避碰 + 与运动参考的一致性三者的组合,早期阶段还加一个归一化前进量的 progress bonus。
数据 / 数字:6 个受限仿真设定下,平均无碰撞任务成功率 52.8%,最强安全基线是 23.7% —— 差了一倍多。同时在无障碍场景里保住了 base policy 的表现(这是「不牺牲任务性能」的关键证据);真机上静态与动态障碍都有一致的碰撞下降,而且 Stem 策略是直接 sim-to-real 的,没有真机训练或微调。
论文自己挖的坑值得单独说:它分析碰撞-自由成功率失败的样本时指出 —— 在静态场景下,抓取这类细粒度阶段附近的局部修正会打断 VLA 动作的连续性,导致抓取失败;而大障碍挡住搬运路径时,几何避让会把执行推离 VLA 的标称动作分布,后续恢复变难。更诚实的一句是:动态场景里相对较低的碰撞率,有一部分其实来自「任务早早失败、轨迹提前终止」的样本。
这句话是我今天最想让你记住的一句:它意味着「碰撞率低」这个指标本身可以被「提前放弃」刷出来。所以这篇坚持报的是「无碰撞任务成功率」这个合取量,而不是分开报碰撞率和成功率。你自己的评测里有没有这种可以被取巧的指标?这是我今天给出的一条最便宜的探针。
工程判断:
- 什么时候抄:你有一个冻结的 VLA(不想动它、也动不起它),但部署环境有空间约束或动态障碍。这套做法的工程性价比很高:底座权重一个不改,新增的是一个独立的、可以单独训练和单独验证的小策略,还能直接 sim-to-real。另一个可抄的点是「保空间意图、放松时间对齐」这个目标定义本身 —— 它可以套到任何「参考轨迹 + 局部修正」的场景。
- 什么时候不抄:你的底座 VLA本来就没有稳定的动作节律(比如输出本身就抖),那「运动参考」这个东西不成立。另外注意蒸馏会继承 teacher 的偏置:teacher 用了特权信息,student 学到的是「有特权时的最优反应」,在真机上特权不存在,这部分泛化要自己验。还有一个隐含前提:Stem 需要局部障碍信息,这个感知模块的噪声会直接进到决策里。
- 一句话启发:「参考轨迹不是用来逐帧执行的,是用来表达意图的。」把参考当命令用,你会同时失去意图和安全。
五、RECREG(Goodall、Belardinelli,arXiv:2610.23445,cs.LG / cs.AI,2026-10-16,CC BY 4.0):「现在安全」是个假命题,安全是整条轨迹的性质
问题:要部署 RL agent,就得满足形式化的安全与约束要求。现有做法大致两派:(A) 把安全写进学习目标(CMDP 那一类),(B) 用外部机制直接改动作(shielding 那一类)。A 派的问题很明确:约束只在期望意义上被满足,不保证不安全事件永不发生;而且指数折扣的代价累计会限制「趋近危险」的行为。B 派里经典的 shielding 更狠:它需要环境的形式模型(安全抽象),从悲观先验构造,于是只能用在已知环境或简单规格上 —— 这跟 RL 的核心前提(环境未知)直接冲突。
关键 idea:RecReg —— 用基于恢复的屏蔽来强制正则(regular)安全性质,注意是非马尔可夫的:安全性是整条轨迹的性质,不是某一时刻的状态性质。几个关键设计:
- 安全概率 = 乘积 MDP 上的可达概率。把 DFA 的状态和安全抽象拼在一起,「违反安全性质」就变成「到达一个标着 unsafe 的乘积状态」,于是可以用概率模型检测算。
- 三种模式对应「你有多少先验知识」:Exact(已知完整转移核,训练一开始就保证安全)、ModelBased(从数据估计转移核 + 有限时域可达性在线验证,带统计保证)、ModelFree(直接估计 safety critic,带收敛保证)。这是我认为这篇最漂亮的地方 —— 它把「我能给多少先验」直接做成了系统的旋钮,而不是先假设一个环境。
- eventual discounting:不管违规发生在轨迹的哪一步,代价都一样 —— 因为「一旦碰过就不安全了」这件事本身没有时间折扣。
- 风险预算怎么摊:朴素做法是均匀分配,通常过于保守;直接扣掉整个尾部风险会重复计算未来风险。论文的做法是只扣当步的即时风险,再按「存活」条件传播剩余预算。
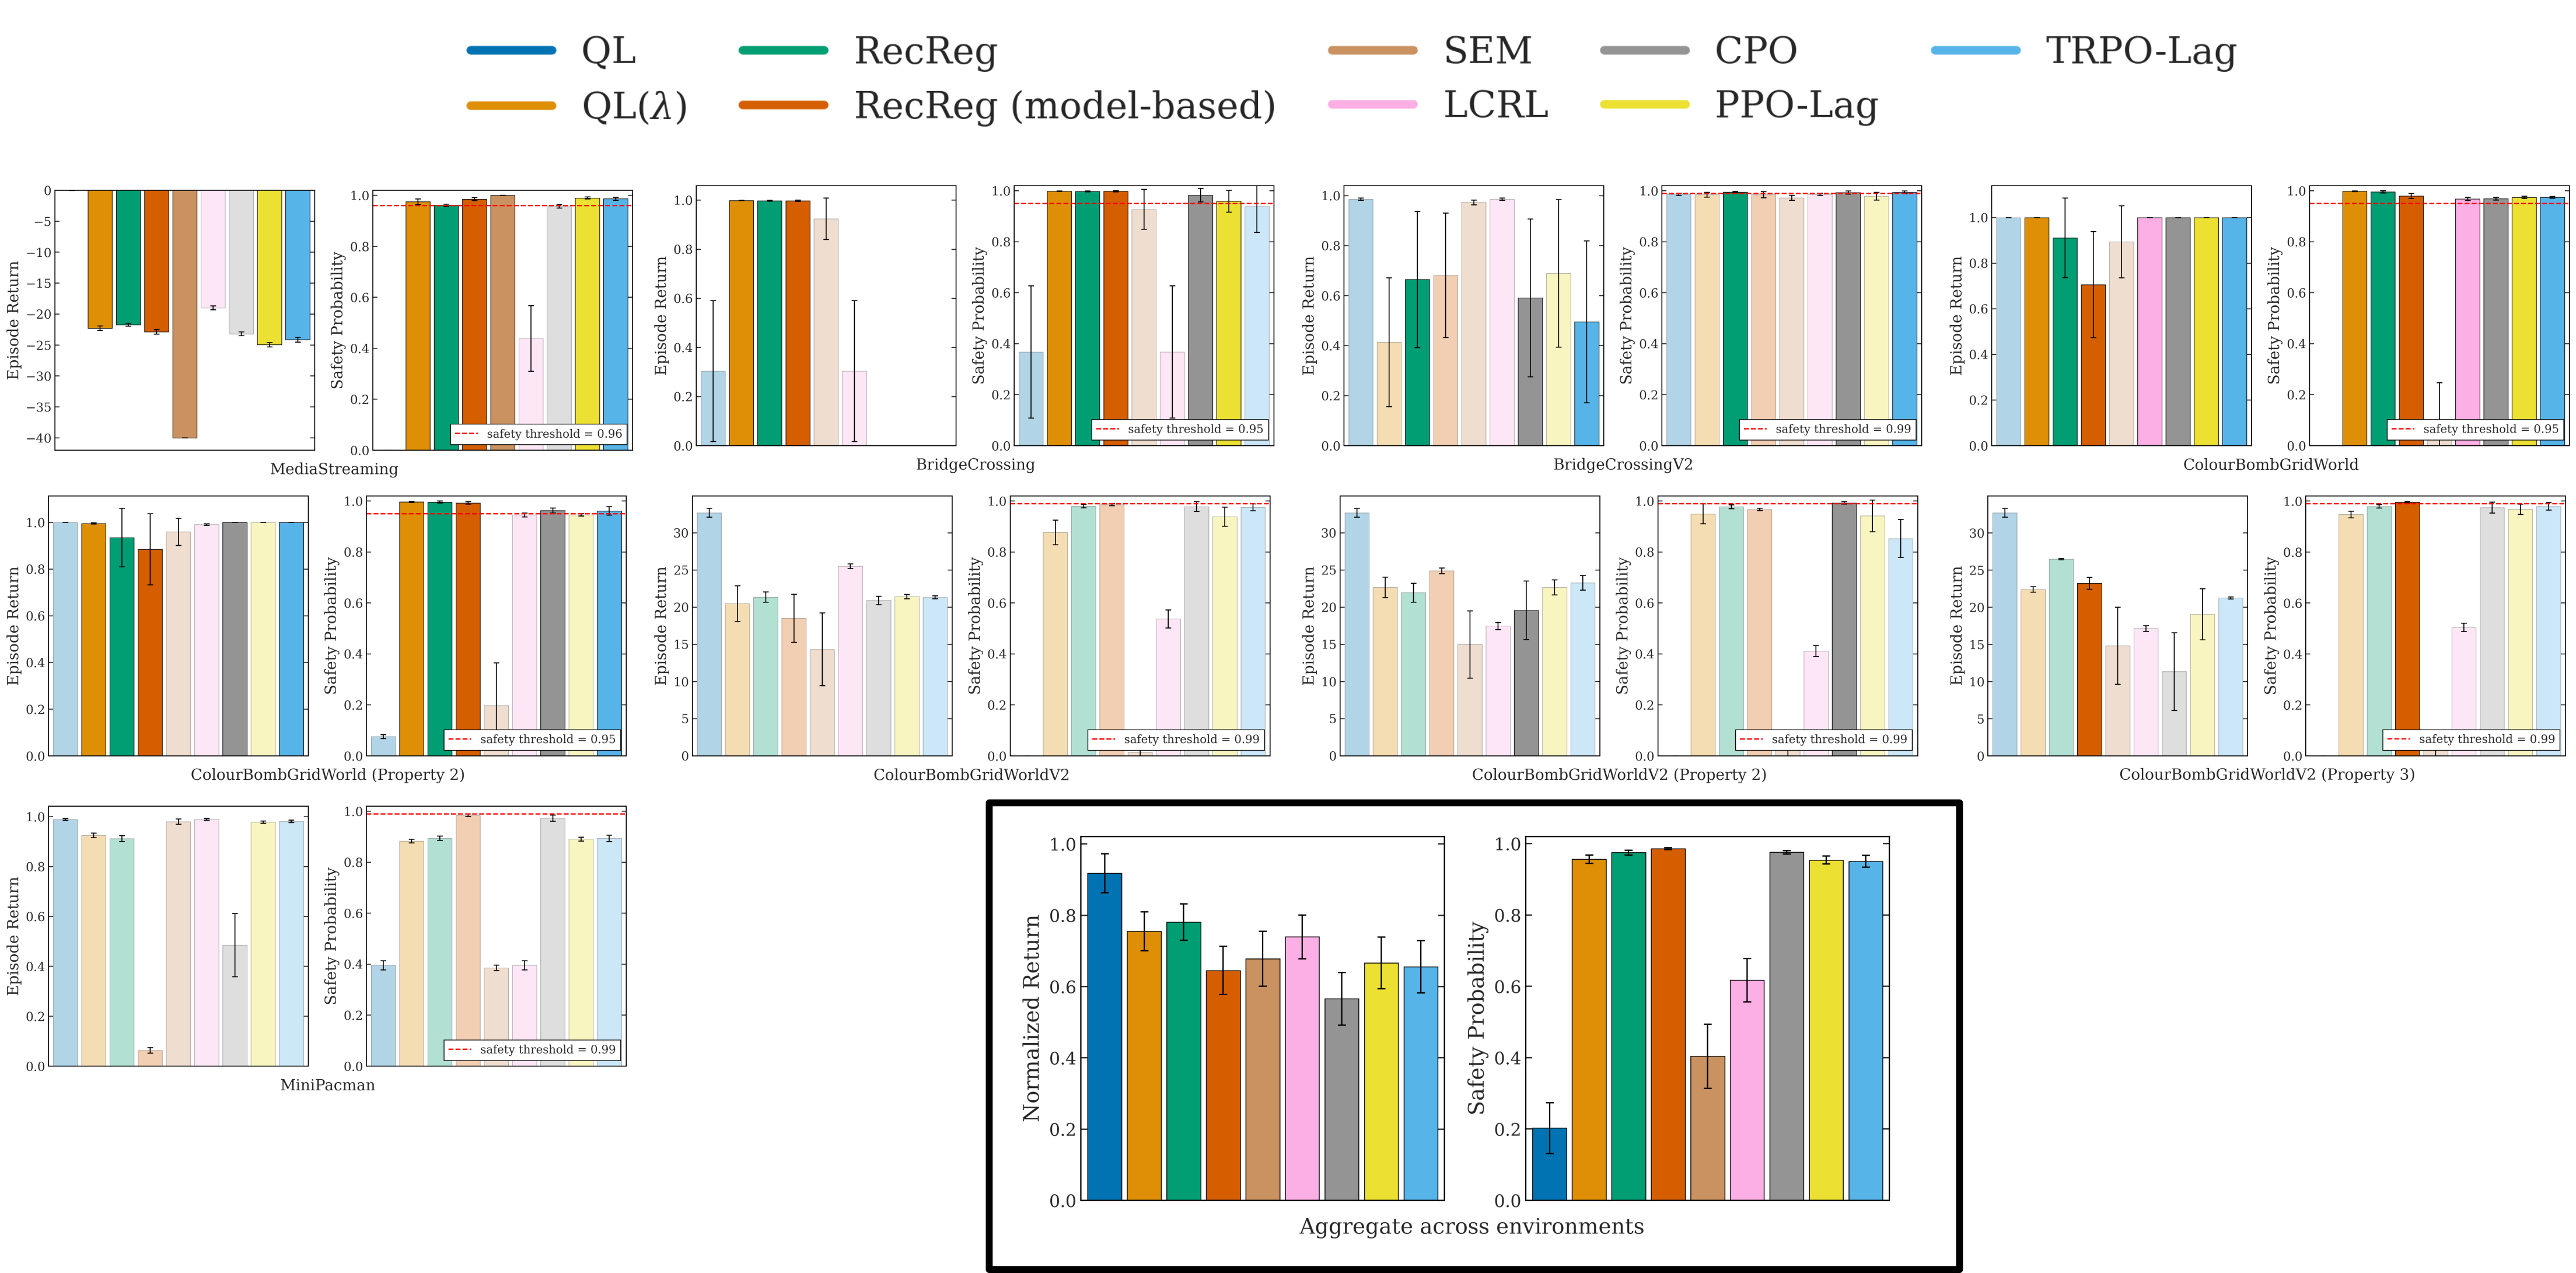
数据 / 数字:表格设定里用 MASA-Safe-RL 套件(网格世界、Pacman、MediaStreaming、BridgeCrossing、ColourBombGridWorld 等),10 个随机种子。论文的结论有两层:两种 RecReg 模式都稳定达到目标安全概率,几乎全部匹配理论约束(偏差主要出现在状态空间较大、估计或探索吃力的环境);而基线的安全表现波动很大,而且即便满足了约束,也常常是以回报下降为代价。深度 RL 侧用 DreamerV3 的 RSSM 加一个 cost head,在 Atari Seaquest 上验两个性质(一个 5 状态 DFA、要求「带着潜水员才能浮出水面、氧气不能耗尽、不能被打中」;一个 31 状态 DFA、要求「一旦捡起潜水员,必须在 30 步内回到水面」),5 个随机种子,对 DreamerV3 + 增广拉格朗日 和 AMBS 两个基线:两个性质上 RecReg 回报最高,同时违规率保持低位。
三句必须说清楚的限定:其一,理论主体在表格设定,深度 RL 是「用 SOTA 模型型 RL 的扩展」,结论要按「扩展」来读,不是「已在高维大规模验证」。其二,Exact 模式需要已知转移核 —— 那等于放弃了 RL 的前提,真正能用的是 ModelFree,而它的保证是收敛性,不是逐时刻硬安全。其三,和 Recovery RL(最接近的基线)的关键差别在于:安全 critic 是相对「安全策略」而不是「任务策略」来学的,所以动作替换不会过度保守 —— 这也是它回报更高的原因。
工程判断:
- 什么时候抄:你要在环境未知的前提下给 RL 加硬安全约束。最值得抄的不是算法,是三种模式的划分本身 —— 先诚实地回答「我对环境知道多少」,再决定要哪一档保证。还有一条可以直接抄进你现有安全 critic 的:风险预算按「只扣当步 + 按存活传播」来摊,比均匀分配省得多,也不会重复计数。
- 什么时候不抄:你的安全要求是马尔可夫的(「不要碰到 X」),那正则性质那套 machinery 是过度设计,用现成 shield 就行。反过来,如果你的安全要求只有近似解释(比如「看起来不安全」),那这篇会显得过于严苛 —— 它的前提是规格本身是确定的。还要注意屏蔽会改变最优策略:它把任务 Q 收敛到「受动作限制的唯一不动点」,这个不动点未必是你原来想要的任务最优解。
- 一句话启发:「安全不是一个状态,是整条轨迹的形状。」能只检查当前状态的安全方案,一定漏掉了「一旦碰过就永久失效」这类性质。
六、DynaFlow(Liu、Li、Wang、Wang,arXiv:2610.34467,新加坡国立大学,cs.MA,2026-10-25,CC BY 4.0):答案对不等于协作可靠
问题:多智能体系统大量依赖预先定义好的协作结构(固定角色、固定通信模式、固定工作流),这限制了它对不同任务需求的适应能力。论文把这类刚性带来的代价说得很直白:不必要的通信、延迟和算力。
关键 idea:提出一个叫 Free Orchestration 的能力 —— 把「自由形式的可执行工作流合成」放进主 agent 的动作空间里。主 agent 同时做三件事:(i) 决定什么时候需要协作;(ii) 现场构造任务专属的程序(通过一个极简执行接口定义子 agent 职责、串行/并行依赖、以及中间结果如何在代码里传递、聚合、验证);(iii) 用返回的输出和执行轨迹决定下一步。一个预算受限的运行时负责执行并回传轨迹,于是主 agent 可以看着执行结果再改下一版工作流。
训练方式很克制,也是这篇的第二个亮点:只训主 agent,所有子 agent 全部冻结 —— 这就把「编排能力」和「执行能力」彻底分开了。分两阶段:Stage 1 用 GLM-5.3 Max 作教师蒸馏 2,031 条首轮样本(QLoRA 微调);Stage 2 只用 712 条经过筛选的样本继续训,筛选标准是三类缺陷:无依据的前提(unsupported premises)、被引导向预期结论的验证(biased verification)、信息传递不完整(information-flow defects)。
数据 / 数字:6 个基准(数学推理、科学问答、多跳检索)上,Forced 模式总体准确率 88.08%,用同一个 Qwen3.5-27B 主干比最强基线高 10.90 个百分点。Dynamic 模式 87.94% —— 几乎不掉,但47.1% 的题根本没用工作流,平均每题 2.44 个子 agent,而 Forced 模式约 4.16 个(省了约 41%)。在 688 道题的子集上,Base 从 75.9% 提到 88.1%。
比准确率更有信息量的是工作流结构的变化:混合(并行 + 串行)工作流占比 3.4% → 83.2% → 85.6%;「把上游输出传下去并明确要求下游使用它」的程序占比 12.6% → 93.3% → 97.7%;重大信息流缺陷 1.9% → 0.9%;会明确写出「对中间结果做修正/精炼」的工作流 28.1% → 35.9%。还有一个数字很能说明问题:Dynamic 与 Forced 的准确率差从 Base 的 10.75pp 缩到 Stage 1 的 1.02pp、再缩到 DynaFlow 的 0.14pp —— 意思是「该不该协作」这个决策本身被学会了,不再需要外力强迫。
两句诚实话:其一,GPQA-Diamond 上 Self-Refine 和 AFlow 仍然领先 —— 论文的失败分析很实在:子 agent 给出的错误中间结论会把后续验证带偏,而主 agent 在综合最终答案时也可能没能优先采信正确证据。其二,Stage 2 之后平均子 agent 数反而略降(4.35 → 4.16),论文把它解读为「协调更聚焦」,但也可以读成「少干活」。论文自己给出的未来工作第一条就是:需要训练子 agent 以保证可靠的信息传递和独立验证 —— 也就是说,当前版本的信息流可靠性仍然压在主 agent 一侧。
工程判断:
- 什么时候抄:你在搭多智能体系统,而且协作结构是手写死的。这篇最值得抄的是「把编排当成一个动作」这个抽象 —— 你不需要一整套工作流 DSL,只需要一个能让 agent 现场写出小程序并拿到执行轨迹的接口。第二条可抄的是Stage 2 的筛选标准:那三类缺陷(无依据前提 / 验证带偏 / 信息传递不完整)是通用的 agent 缺陷分类,你可以拿它去筛自己的示范数据,不需要改架构。
- 什么时候不抄:你的子 agent 能力参差不齐且不打算改 —— 这篇整套方法建立在「子 agent 固定、只提升编排」的前提上,前提不成立时收益要重估。另外,多智能体的收益本身就不稳定:论文自己给了反例 —— 更多 agent 不一定更好(Dynamic 模式省掉 41% 的 agent 反而准确率几乎不掉)。所以先做那个便宜的对照:你的系统里,有几个 agent 是真在贡献的?
- 一句话启发:「答案对,不代表过程可靠;而不可靠的过程迟早会在某道题上把答案弄错。」用答案正确率当唯一标尺,你会永远看不见协作质量的问题。
七、落地思考 / 我的判断
把这 6 条抽成一句话:「这 6 篇里有 6 篇的失败表现,都是『你用来打分的那个量,和真正在乎的那个量,不是同一个东西』。」这和 10-26(改约定)、10-27(约定坏掉时不报错)、10-28(均匀对待)构成一条完整的线。今天补的是第四层 —— 上一轮你说「该加权」,这一轮问「加权的那个代理,本身选对了吗」。
我按这 6 篇各给一条探针,都是从零成本开始的:
- 文本世界模型(GlobeBench)→ 造一组「后果要传播到依赖对象」的任务,看你的模型会不会在简单任务上很行、一到传播就塌。如果塌,说明它学的是表面连贯性。
- 像素世界模型(Latent WAM)→ 把你训练好的世界模型生成的未来和当前帧比一下。如果「几乎不变」的比例很高,你就是在给恒等捷径发奖金。
- 条件视频生成(WorldCast)→ 把轨迹误差和身份相似度分开报。再对你的生成结果做一次「未观测区域」标注,看看模型在自己看不见的地方编了多少。
- VLA 安全(VLA-Stem)→ 检查你的安全指标能不能被「提前放弃」刷高。把碰撞率和任务成功率合成一个合取量再看。
- 安全 RL(RECREG)→ 问一句「我检查的是当前状态,还是整条轨迹?」如果你的性质里有「一旦碰过就永久失效」这种,现在的检查必然漏。
- 多智能体(DynaFlow)→ 统计你每个 agent 的实际贡献。有几个是从来不起作用的?把最终答案正确率和你流程里的信息传递质量分开看。
我的取舍:
- 最该先做的是 Latent WAM 的那条探针。理由是投入产出比:不用改架构、不用改数据,只是在已有的损失里换一个判别式目标,而收益是 +31.9%/+40.6%,推理期还省 98.9%。而且它顺带回答了 10-28 留下的问题 —— 「哪些东西该加权」的答案之一就是「换一个能真正区分的损失」。
- 第二该做的是 VLA-Stem 那个合取指标。成本是零(改一下报表口径),但它防住的是最坏情况:你可能一直在用「碰撞率低」证明自己安全,而那批数据里有一部分只是任务早死了。这条不需要任何新方法,只需要你去查一下自己的失败样本里「提前终止」占多少。
- 最被低估的是 RECREG 的「三种模式」这个划分。它的价值不在算法,在于它把「安全保证有多硬」这个模糊问题,变成了「你对环境知道多少」这个可以回答的问题。凡是你在纠结「要不要上形式化方法」的场合,先按三档给自己定位,会省掉很多无效争论。
- DynaFlow 是这批里最容易被误读的一个。它的 88.08% 是 Forced 模式(强制走工作流);真正该看的是 Dynamic 模式的 87.94% + 47.1% 直接回答 + 41% 的 agent 节省 —— 那才是「学会了什么时候该协作」的证据。如果你只引用那个 88.08%,就丢掉了这篇最有价值的部分。
- GlobeBench 那个 5.1% 我建议直接当探针用,别当结论用。它是文本世界模型的结论,不能直接搬到像素/潜空间世界模型上(而你大概率用的是后者)。但「后果要传播到依赖对象」这个任务设计可以平移到任何世界模型上。
- WorldCast 是唯一一篇我建议「抄思路、别抄实现」的。它的方法依赖 UE5 + Blender + 多视角锚点这套管线,而最可移植的是覆盖率掩码那个思路:显式标出「我没见过、别装懂」。
- 必须保留的五个 caveat。其一,Latent WAM 的 Grounding 提升明显弱于 Type,而且论文自己报告最终 token 表征在残差分析下不区分动作类型。其二,VLA-Stem 的动态场景低碰撞率有一部分来自早期任务失败 —— 引用这个数字必须带上这句。其三,RECREG 的理论主体在表格设定,深度 RL 是扩展而非验证,且真正可用的是 ModelFree 模式。其四,WorldCast 的 IQ 不是第一(0.719 对 Lyra 2.0 的 0.725),它赢在轨迹和身份。其五,GlobeBench 的结论限定在文本世界模型。
- 今天没解决的老问题还在,而且今天变得更尖锐了。我 10-27 提的「这些方法的评测构造由谁来独立审计」,今天依然没人回答。但今天多了一层:如果连「该用什么尺子」都要靠论文作者来定,那尺子的可信度问题就更严重了。GlobeBench 用「确定性闸门 + 语义 judge」双重判分,是往这个方向走的一步;但 GlobeBench 自己的 1,632 个任务和 631 个「无人能解」,同样没有第三方复核。RECREG 用形式化 DFA 显得硬,但「该写哪条正则」还是人写的。今天这 6 篇的共同成就,是把「谁说了算」这个问题从暗处搬到了明处;但搬到明处不等于解决。
| 论文 | 主题 | 被误用的「尺子」 | 真实目标 | 关键数字 |
|---|---|---|---|---|
| GlobeBench 2610.22708 | 文本世界模型评测 | 下一步描述像不像 | 后果能不能传播到依赖对象 | 1,632 任务 / 5 领域 / 19 技能;GPT-6 Astra 最高 49.57%;依赖传播平均仅 5.1%;631 任务无人能解 |
| Latent WAM 2610.14228 | 世界模型 · GUI 控制 | 全屏像素重建 | 动作诱发的未来变化 | 对像素世界模型 +31.9%(离线)/ +40.6%(在线);对 base agent +11.6% / +47.0%;推理延迟 -98.9%;OOD 下像素模型反而低于 base |
| WorldCast 2610.33135 | 控制式生成 · 相机 | 相机轨迹误差 | 轨迹 + 几何 + 身份三者同时成立 | ATE 0.065(Uni3C 0.098);ArcFace 0.555(GEN3C 0.433);去 GAMA 后 ArcFace 崩到 0.370;IQ 0.719 非第一 |
| VLA-Stem 2610.37378 | safe VLA | 逐时刻动作对齐 | 空间意图 + 不碰撞(合取) | 6 个受限仿真设定无碰撞任务成功率 52.8% vs 最强安全基线 23.7%;底座零改动;sim-to-real 无真机训练 |
| RECREG 2610.23445 | safe RL | 当前状态安不安全 | 整条轨迹满足正则安全性质 | Exact / ModelBased / ModelFree 三档;安全概率 = 乘积 MDP 可达概率;DreamerV3 + Seaquest 两个 DFA 性质上回报最高且违规率低 |
| DynaFlow 2610.34467 | agentic control | 最终答案对不对 | 协作过程可靠、信息流完整 | Forced 88.08%(+10.90pp);Dynamic 87.94% 且 47.1% 直接答、agent 省 41%;混合工作流 3.4%→85.6%;显式传递上游输出 12.6%→97.7% |
References
- Saban, Bannur, Vasileva, Deshpande (2026). GlobeBench: Evaluating Text-Based World Model Capabilities for Scalable Environment Simulations. arXiv:2610.22708. cs.AI / cs.CL; submitted 2026-10-15; Patronus AI; License: CC BY 4.0。代码:github.com/patronus-ai/globebench · 数据:huggingface.co/datasets/PatronusAI/globebench
- Yu, Choi, Park, Shin, Shim (2026). Latent World Action Model for GUI Agents. arXiv:2610.14228. cs.CV / cs.AI / cs.HC; submitted 2026-10-09; KAIST; License: CC BY 4.0。代码:github.com/sjyu001/latent2world
- Cao, Liu, Liao, Zhang, Wang, Zhang, Le, Zhou, Luan, Ma (2026). WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control. arXiv:2610.33135. cs.CV; submitted 2026-10-23; 30 页,14 图,3 表;武汉大学 / 小米 MiLM Plus 等。
- Zou, Yu, Li, Lin, Ye, Geng, Yu, Zhang, Ji (2026). VLA-Stem: A Lightweight Safety Mechanism for Vision-Language-Action Models via Reinforcement Learning. arXiv:2610.37378. cs.RO; submitted 2026-10-27; 12 页,5 图;中国科学技术大学 / 澳门大学。
- Goodall, Belardinelli (2026). RECREG: Recovery-based Shielding for Regular Safety Properties in Reinforcement Learning. arXiv:2610.23445. cs.LG / cs.AI; submitted 2026-10-16; License: CC BY 4.0。基准库:github.com/sacktock/MASA-Safe-RL
- Liu, Li, Wang, Wang (2026). DynaFlow: Learning Free-Form Multi-Agent Orchestration. arXiv:2610.34467. cs.MA; submitted 2026-10-25; 新加坡国立大学; License: CC BY 4.0。
下一篇预告:今天把「代理目标和真实目标错位」这层补上了。但今天这 6 篇都还有同一个没回答的问题 —— 「真实目标」本身是谁定的?GlobeBench 说真实目标来自环境执行记录,RECREG 说来自形式化 DFA,DynaFlow 说来自人工标注的缺陷类别,WorldCast 说来自几何与身份度量。这些「真实」本身都是人造的。下一层要处理的,是当你的尺子、你的规范、你的标注全都是一个团队自己定的时候,谁给你一个外部的参照系。这已经不是方法问题了,是组织问题 —— 也是这条线迟早要撞上的那堵墙。