给冻结的 VLA 套一个安全外壳:CarryOn 双环机器人助手拆解
现在让机器人"做三明治"还做不到,但让它"把胡萝卜放进碗里"已经不难了。剩下的鸿沟不在能力,在两件事:它不知道你个人的偏好,以及它不知道什么时候该刹车。CarryOn(2026)没有去改 VLA 的权重——它把一个冻结的策略包进了两个环里,让安全性和个性化变成外壳而不是训练目标。
我关注这篇的原因是数字够狠:一个已经做过安全微调的 VLA,违规率从 52.6% 降到 6.1%,同时恢复成功率从 13% 拉到 80%,而 VLA 本身一个权重都没动。

一、双环结构
整个系统只有两个环,共用一份视觉上下文:
规划环:维护用户级和场景级的持久上下文,持续地用新观测去校准它,并通过交互修订。这样"做三明治"才能拆成符合这个用户习惯的子任务,而不是一套通用解。
执行环:主动监督策略的 rollout。两个动作:屏蔽——用预测的危险接触把危险动作挡掉;恢复——执行失败时调用可复用的控制式恢复技能把任务进度拉回来,并通过反思失败经验来改进这些技能。
关键设计取舍:LLM 和 VLM 走 API,VLA 在本地跑。规划、反思这些"慢思考"可以外包给大模型,但真正的动作执行必须留在低延迟的本地闭环里。
二、安全:不是重训,是运行时几何过滤
先看最有说服力的一组数。论文在 LIBERO-Safety 上测了两个套件(TSA 桌面空间避障、FSHOA 自由空间手-物避障),每个套件 450 回合。指标是无违规任务成功率 / 违规率。
| 方法(全体环境) | 无违规成功率 ↑ | 违规率 ↓ |
|---|---|---|
| π0.5(原版) | 6.7% | 71.1% |
| π0.5 + VLSA | 12.7% | 49.8% |
| π0.5 + Ours | 14.6% | 22.7% |
| π0.5-SFT(安全微调版) | 25.3% | 52.6% |
| π0.5-SFT + VLSA | 25.4% | 37.7% |
| π0.5-SFT + Ours | 25.6% | 6.1% |
读这张表要注意两件事:
第一,"做过安全微调"不等于安全。π0.5-SFT 是官方发布的、用了 19,664 条安全演示训练的 checkpoint,违规率仍有 52.6%。这是整篇文章最有冲击力的一个事实——用示范数据做安全微调,能提高无违规成功率(6.7% → 25.3%),但对"至少有一步违规"的抑制几乎无效。微调学到的是"通常怎么走",不是"什么时候绝不能走"。
第二,屏蔽几乎不损伤任务性能。加 Ours 之后,无违规成功率从 25.3% 微升到 25.6%,违规率却从 52.6% 塌到 6.1%。这个"降违规不降性能"的组合,正是运行时几何过滤相对重训路线的核心优势:过滤只拒绝那些预测会撞的动作,不改动策略本身的偏好。
2.1 跨 backbone 可迁移
这组数字很重要,因为它说明这不是对某一个 checkpoint 的过拟合:
- OpenVLA-OFT:VLSA 42.0% → Ours 17.2%,无违规成功率 12.3% → 14.8%。
- VLAct:VLSA 44.8% → Ours 26.1%,成功率 13.0% → 13.9%。
VLAct 上的降幅(44.8% → 26.1%)明显小于 π0.5 系列,说明基座策略越强,外壳的收益越大。如果你的 VLA 本来就不太行,加个安全壳只是让它少撞,并不会让它变能干。
2.2 机制:几何动作过滤 + 后退
屏蔽的实现是纯几何的:预测夹爪与障碍物的距离,超过阈值就拦住当前动作并执行后退。机制细节见下图——在第一次越过距离阈值之前就放行动作,一旦越界则执行后退,而不是等碰撞发生后再补救。
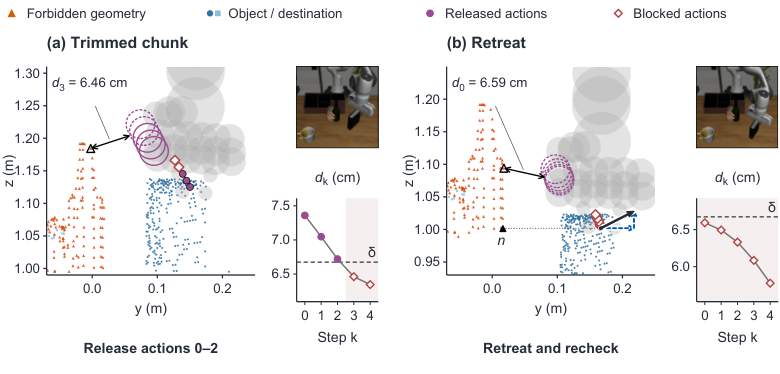
代价极低——论文给了实测的每次调用平均耗时:
- 几何过滤 21.06 ms
- VLA 推理 47.82 ms
- 感知 170.82 ms
感知才是瓶颈,过滤只占两成不到。这是个很实用的结论:如果你要给 VLA 加安全层,不要在感知上省钱——那才是时延的大头;但也不必为了安全层去做重训。
2.3 真机验证
仿真数字好看不算数。论文的真机实验:策略在没有障碍物的条件下训练,然后事后插入一个障碍物。无接触完成率从 0/20 变成 20/20。这个对照设计很干净——它测的是"面对训练时没见过的分布外障碍,运行时过滤能否救场",答案是能。
三、恢复:13% → 80% 靠的是"复用"
另一半是执行失败后怎么办。论文在 LIBERO-Object 上施加 12 cm 的正向 x 方向持物丢失扰动,200 回合:
| 系统 | 累计完成 / 200 | 每回合 API token |
|---|---|---|
| Qwen3-VL-OFT(纯 VLA) | 26(13.0%) | — |
| CaP-X | 10(5.0%) | 1,124,819 |
| Harness VLA | 101(50.5%) | 3,829,605 |
| CarryOn R0(基础技能) | 58(29.0%) | 21,371 |
| CarryOn R1(一次反思) | 141(70.5%) | 34,393 |
| CarryOn R2(两次反思) | 160(80.0%) | 41,109 |
注意最后一列。CaP-X 花了 112 万 token 换 5% 完成率,Harness VLA 花了 383 万 token 换 50.5%,而 CarryOn 花 4.1 万 token 换 80%。token 成本差了 30~90 倍,完成率还高得多。这说明 CarryOn 的恢复不是"让大模型反复重试",而是调用可复用的控制式恢复技能——一个底层的"松手—重抓—复位"原语,参数化之后被复用和精化。
分层看增量也很清楚:R0 基础技能解决 29%,R1 一次反思把 142 个失败回合里的 83 个救回来(70.5%),R2 又救回 59 个中的 19 个(80.0%)。第二轮反思依然有收益但明显递减——工程上意味着做两次就够了,别指望无限迭代。
在 770 个 LIBERO-Recovery Object 案例上趋势一致:纯 VLA 32.08% → R0 50.00% → R1 73.90% → R2 76.10%,token 只有 7,159/回合。
四、个性化:记忆的价值是省时间
规划环这部分的数字没那么惊艳,但方向清楚:记忆主要买的是时延和正确率,不是新能力。
- RoboLab 静态场景(88 个请求):纯文本 77/88 正确、28.6 秒;加记忆后 88/88 正确、7.0 秒。图像查询同样从 34.6 秒降到 7.1 秒。
- 偏好保持:对话中准确率 100%(24/24),偏好更新后 83.3%(20/24)。
- 场景记忆修订:文本 76/88 纠正成功,图像 77/88;后续请求正确率 83/88 和 85/88。
- 覆盖食材检索:记忆 100%(12/12),无记忆 80%(8/10),过期记忆 75%(9/12)。
4 倍的时延下降是最实用的那一条。没有记忆时规划器要逐个开盖子观察才能找到目标,有了记忆直接去——这是把"感知开销"换成"存储开销"。
五、我的判断
这篇论文给出了一个我认为应该被广泛采纳的架构模式:
- 安全应该是运行时约束,不是训练目标。52.6% 这个数字应该让所有打算"用安全演示微调 VLA"的团队停下来想一想——那条路在统计上是在学"平均行为",不是学"边界"。运行时几何过滤用 21 ms 换来 8.6 倍的违规率下降,这个交易太划算了。
- "冻结基座 + 外挂壳"的思路适合绝大多数存量场景。你的 VLA 训完了、跑起来了、效果不错——你不需要重训它去解决安全、个性化、失败恢复这三件事。这三个都可以做成可插拔的外壳,分别对应不同的接口契约(动作流 / 子任务序列 / 恢复原语)。
- 恢复技能要"参数化 + 复用",不要"让 LLM 重试"。token 成本 30~90 倍的差距说明了一切。可复用原语 + 少量反思精化,是这个问题的正确解法。
要留意的局限:
- 安全指标依赖任务定义。"违规"在 LIBERO-Safety 里是预设的接触约束,真实世界的"安全"包含更模糊的东西(别打碎杯子、别把水洒了)。几何过滤能挡碰撞,挡不住"做得难看"。
- 感知仍是时延瓶颈(170 ms)。安全层加进来之后,整个闭环的节奏由感知决定。如果你在意端到端时延,先优化感知而不是急着叠更多层。
- 个性化收益依赖场景结构。RoboLab 里只有车库/餐桌/厨房/书桌四个端点,换到开放环境,"记忆该记什么、什么时候该失效"会重新变成难题。论文里"修订过期记忆"只有 76~77/88 的纠正率,说明这部分还没到可靠的程度。
- 反思轮次的边际收益递减明显(R1→R2 只涨 9.5 个百分点)。真机上每一轮反思都意味着延迟和 token 成本,要按业务 SLA 精打细算。
一句话总结:CarryOn 说明"安全"和"可靠"可以做成 VLA 的外挂运行时,而不是 VLA 的训练目标——对于已经训好策略的团队,这可能是投入产出比最高的一条路。
参考资料
- 论文:CarryOn: A Dual-Loop Harness for Personalized and Reliable Robot Assistance — Zixuan Wang, Yuqi Liu, Yuxin Chen, Sengqiao Yang, Jinhui Ye, Pengguang Chen, Changsheng Lu, Shu Liu, Bei Yu, Jiaya Jia,arXiv:2610.21453,2026
- 项目页:https://vincent2311.github.io/Projects/CarryOn/
- 许可:CC BY 4.0(本文引用图均出自该论文并已标注出处)